



A medida que los modelos de IA siguen escalando, la conectividad en red se ha vuelto tan importante como el rendimiento de la GPU . Las cargas de trabajo de IA modernas dependen de clústeres de GPU distribuidos que generan un tráfico masivo en ambas direcciones durante el entrenamiento y la inferencia, lo que hace que una conectividad de baja latencia y alto ancho de banda sea esencial para la eficiencia general del sistema.
Aquí es donde la interconexión de clústeres de IA desempeña un papel fundamental.
La interconexión de clústeres de IA se refiere a la infraestructura de red de alto rendimiento que conecta servidores GPU, sistemas de almacenamiento y aceleradores de IA dentro de centros de datos de IA y entornos HPC. A diferencia de las redes empresariales tradicionales, los clústeres de IA requieren una comunicación ultrarrápida entre nodos para admitir marcos de computación distribuida como NCCL y la comunicación GPU basada en RDMA .
Para reducir los cuellos de botella y maximizar la utilización de la GPU, las arquitecturas de IA modernas suelen utilizar tecnologías como:
-
InfiniBand
-
RoCEv2 y RDMA
-
Redes Ethernet sin pérdidas
-
Arquitecturas de red de tipo espina-hoja
-
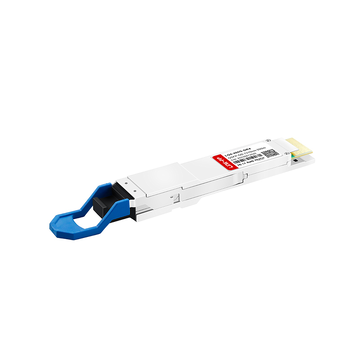
Interconexiones ópticas QSFP de 400G y OSFP de 800G
En la capa física, los módulos ópticos se han convertido en una parte fundamental del diseño de la infraestructura de IA. Los transceptores ópticos de alta velocidad, como los módulos QSFP-DD y OSFP, permiten una conectividad escalable de 400G y 800G entre conmutadores y servidores GPU, manteniendo una baja latencia y una alta densidad de puertos.
En esta guía, explicaremos cómo funciona la interconexión de clústeres de IA, compararemos las arquitecturas InfiniBand y RoCEv2, examinaremos las tecnologías RDMA y de control de congestión, y exploraremos cómo los módulos transceptores ópticos permiten la escalabilidad de los clústeres de IA modernos en 2025 y en adelante.
⭐ ¿Qué es la interconexión de clústeres de IA?
La interconexión de clústeres de IA se refiere a la infraestructura de red de alto rendimiento utilizada para conectar servidores GPU, aceleradores de IA, sistemas de almacenamiento y conmutadores dentro de centros de datos de IA y entornos de computación de alto rendimiento (HPC) . Su objetivo principal es permitir un intercambio de datos extremadamente rápido entre nodos de computación durante cargas de trabajo de IA distribuidas.
En términos de ingeniería práctica, las redes de clústeres de IA están diseñadas para resolver un problema crítico: mantener las GPU completamente utilizadas durante las tareas de entrenamiento e inferencia a gran escala. Dado que los modelos de IA modernos son demasiado grandes para ejecutarse de manera eficiente en una sola GPU o incluso en un solo servidor, las cargas de trabajo se distribuyen entre múltiples nodos que deben sincronizar constantemente los datos entre sí. Por lo tanto, la red se convierte en parte del propio sistema de computación, en lugar de ser solo una capa de transporte.
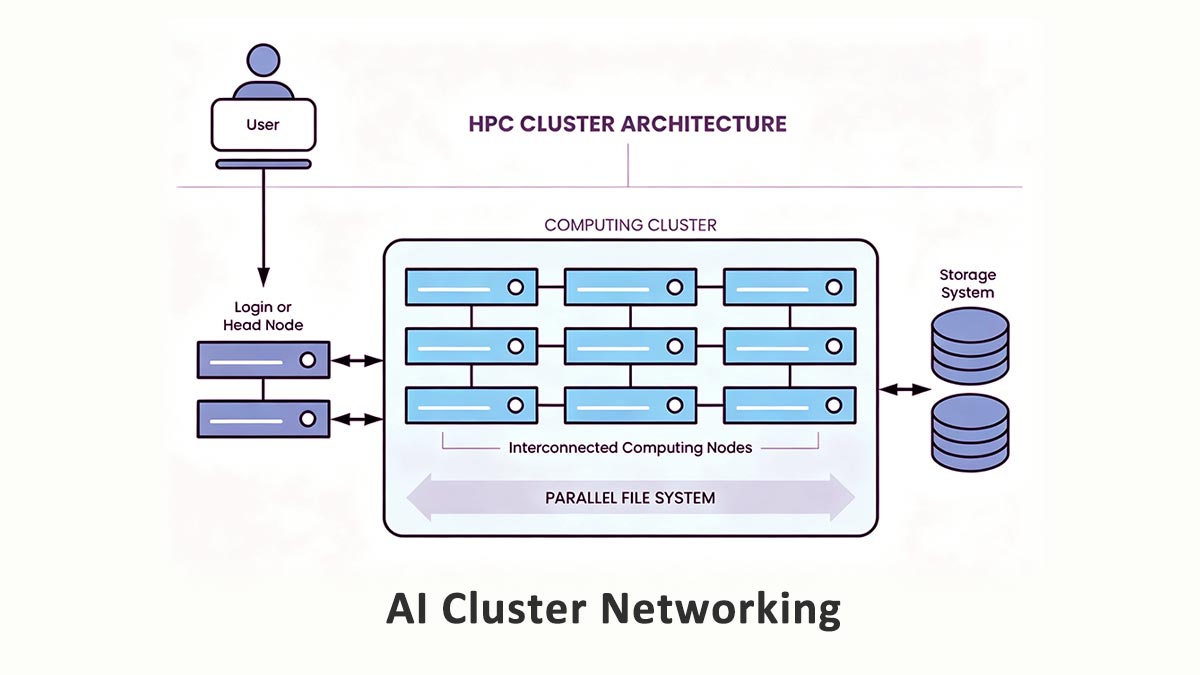
A diferencia de las redes empresariales convencionales, que gestionan principalmente la comunicación entre usuarios y servidores, los clústeres de IA generan enormes cantidades de tráfico este-oeste : datos que se mueven lateralmente entre las GPU, los servidores y los sistemas de almacenamiento dentro del centro de datos.
Por qué el tráfico este-oeste domina el entrenamiento de la IA
El entrenamiento distribuido de IA requiere que las GPU intercambien continuamente gradientes, tensores, parámetros del modelo y datos de sincronización. Durante operaciones como el paralelismo de datos, el paralelismo de tensores y el paralelismo de pipeline, cada GPU puede comunicarse con muchas otras GPU simultáneamente.
Esto genera patrones de tráfico este-oeste que consumen un ancho de banda extremadamente elevado.
Por ejemplo, durante el entrenamiento de modelos de lenguaje grandes (LLM) , las GPU realizan con frecuencia operaciones de comunicación colectiva tales como:
-
Reducción total
-
Reunión general
-
Radio
-
Reducir la dispersión
Estas operaciones generan un tráfico entre nodos intenso que es altamente sensible a:
-
Estado latente
-
Congestión
-
Jitter
-
Sobrecarga de red
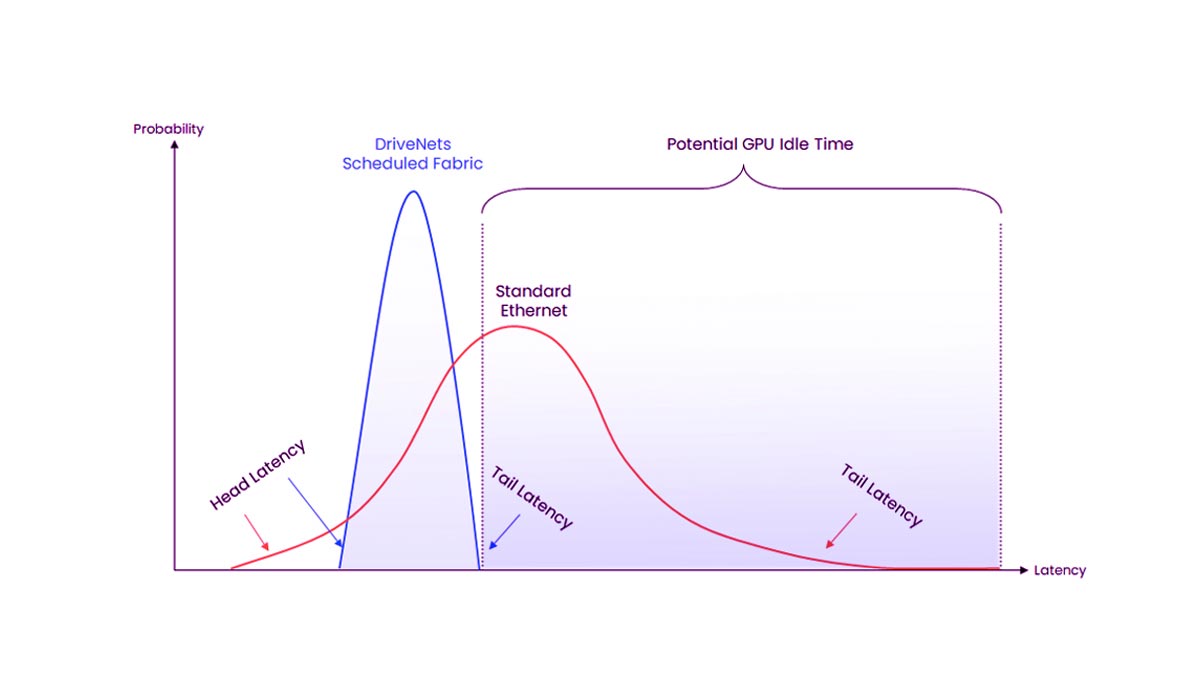
Incluso pequeños retrasos en la sincronización pueden dejar inactivas las costosas GPU, lo que reduce significativamente la eficiencia del clúster y aumenta el tiempo de entrenamiento.
Debido a esto, los entornos de redes de IA suelen implementar lo siguiente:
-
Topologías de espina-hoja sin bloqueo
-
Tejidos compatibles con RDMA
-
Ethernet sin pérdidas o InfiniBand
-
Interconexiones ópticas de 400G y 800G
-
Mecanismos inteligentes de control de la congestión
El objetivo es minimizar la sobrecarga de comunicación y mantener un rendimiento predecible de baja latencia en todo el clúster.
Requisitos de redes para entrenamiento e inferencia
Si bien tanto el entrenamiento como la inferencia de la IA dependen de redes de alta velocidad, sus patrones de tráfico y requisitos de infraestructura son muy diferentes.
1. Redes de entrenamiento de IA
Los entornos de entrenamiento de IA priorizan:
-
Latencia ultrabaja
-
Alto rendimiento
-
eficiencia de sincronización de la GPU
-
Gran capacidad de ancho de banda este-oeste
-
Optimización de RDMA y comunicación colectiva
Los clústeres de entrenamiento suelen utilizar redes InfiniBand o RoCEv2 con módulos ópticos de 400G/800G para admitir la comunicación continua entre GPU a gran escala.
2. Redes de inferencia de IA
Las cargas de trabajo de inferencia suelen estar más centradas en:
-
Rápido tiempo de respuesta
-
Escalabilidad para las solicitudes de los usuarios
-
gestión del tráfico norte-sur
-
Eficiencia de costo
-
Balanceo de carga
Los clústeres de inferencia pueden no requerir el mismo nivel de sincronización de latencia ultrabaja que los entornos de entrenamiento, especialmente para cargas de trabajo de inferencia de un solo nodo o ligeramente distribuidas. En muchos casos, las redes Ethernet de alta velocidad son suficientes.
Sin embargo, a medida que las aplicaciones de inferencia distribuida a gran escala y de IA generativa en tiempo real siguen creciendo, los requisitos de las redes de inferencia también se vuelven más exigentes, especialmente para las arquitecturas de servicio de IA de múltiples nodos.
⭐ Arquitecturas de red para clústeres de IA: InfiniBand, RoCEv2 y Ethernet
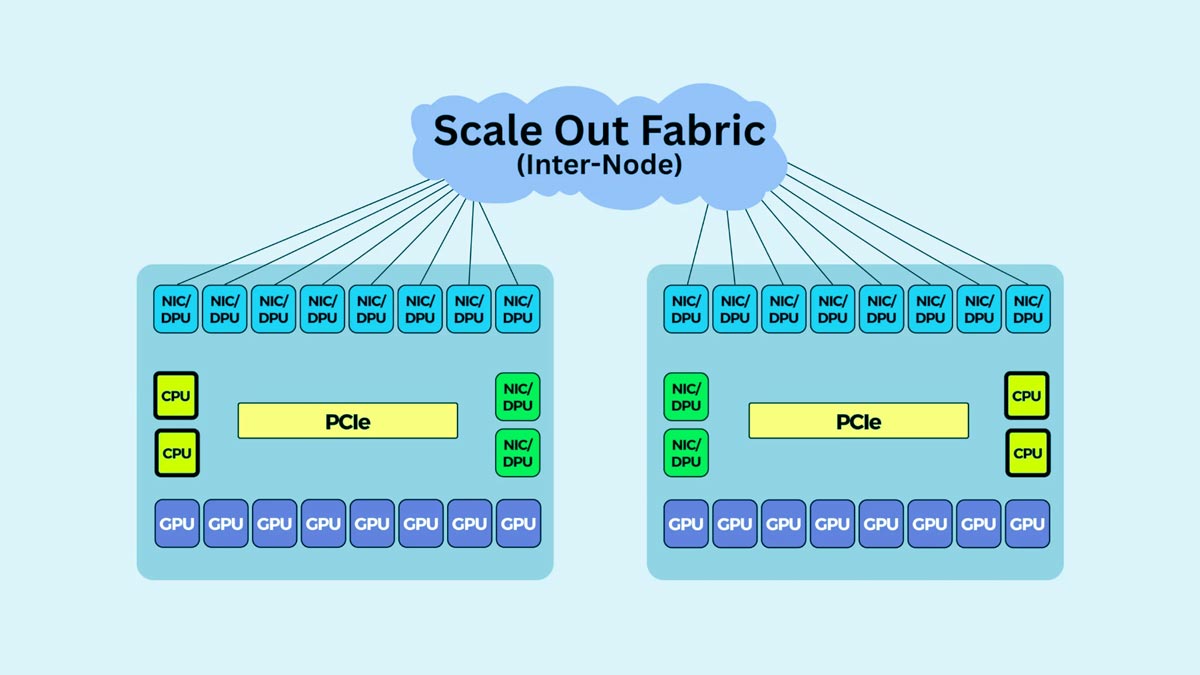
Seleccionar la arquitectura de red adecuada para un clúster de IA influye directamente en la utilización de la GPU, la latencia, la escalabilidad y el coste de implementación. Actualmente, la mayoría de las infraestructuras de IA se basan en tres enfoques principales: InfiniBand, RoCEv2 y Ethernet estándar.
InfiniBand
InfiniBand se utiliza ampliamente en entornos de entrenamiento de IA a hiperescala y computación de alto rendimiento (HPC) porque ofrece latencia ultrabaja, alto rendimiento y control de congestión avanzado. Está optimizado para RDMA y comunicación GPU a gran escala, lo que lo hace ideal para cargas de trabajo de entrenamiento de IA distribuidas.
Las ventajas clave incluyen:
-
Latencia extremadamente baja
-
Alta eficiencia de comunicación de la GPU
-
Fuerte rendimiento RDMA
-
Excelente escalabilidad para grandes clústeres.
Sin embargo, InfiniBand también tiene costos más elevados y una mayor complejidad de implementación, lo que lo hace más adecuado para:
-
Grandes clústeres de entrenamiento de IA
-
Entornos HPC
-
Implementaciones de GPU en múltiples racks
RoCEv2
RoCEv2 (RDMA sobre Ethernet convergente) incorpora capacidades RDMA a las redes Ethernet. Ofrece un excelente equilibrio entre rendimiento, escalabilidad y coste, a la vez que se integra con mayor facilidad en la infraestructura empresarial.
Entre los beneficios de RoCEv2 se incluyen:
-
Menor costo que InfiniBand
-
Compatibilidad con Ethernet de alta velocidad
-
Buena escalabilidad para cargas de trabajo de IA.
-
Integración empresarial más sencilla
Para lograr un rendimiento estable, RoCEv2 requiere una configuración adecuada de tecnologías Ethernet sin pérdidas, como PFC y ECN.
RoCEv2 se utiliza comúnmente en:
-
clústeres de IA empresarial
-
Infraestructura de IA en la nube
-
Entornos de GPU de tamaño mediano a grande
Ethernet estándar
La conexión Ethernet estándar sigue siendo una opción práctica para implementaciones de IA y clústeres de inferencia más pequeños, donde la sincronización de GPU de latencia ultrabaja es menos crítica.
Las ventajas incluyen:
-
Menor costo de implementación
-
Gestión simplificada
-
Amplia compatibilidad
-
Escalado flexible
Las modernas redes Ethernet de 100G y 400G pueden soportar eficazmente muchas cargas de trabajo de inferencia de IA, aunque es posible que no igualen a las redes basadas en RDMA para el entrenamiento distribuido a gran escala.
InfiniBand vs. RoCEv2 vs. Ethernet
|
Elemento |
InfiniBand |
RoCEv2 |
Ethernet |
|---|---|---|---|
|
Estado latente |
Más bajo |
Muy bajo |
Moderado |
|
Compatibilidad con RDMA |
Nativo |
Soportado |
Limitada |
|
Costo |
Mayor |
Media |
Más bajo |
|
Complejidad: |
Alto |
Media |
Bajo |
|
Mejor caso de uso |
Entrenamiento de IA a gran escala |
clústeres de IA empresarial |
Inferencia y despliegues más pequeños |
En general, InfiniBand sigue siendo la mejor opción para obtener el máximo rendimiento en el entrenamiento de IA, RoCEv2 ofrece el mejor equilibrio entre coste y escalabilidad, y Ethernet estándar suele ser suficiente para entornos de IA centrados en la inferencia.
⭐ Cómo diseñar una arquitectura de IA de baja latencia
Diseñar una arquitectura de IA de baja latencia es fundamental para mantener una alta utilización de la GPU y un entrenamiento distribuido eficiente. En los clústeres de IA modernos, la red debe soportar un tráfico masivo bidireccional con una mínima congestión, pérdida de paquetes y retardo de sincronización.
Arquitectura de espinas y hojas y sin bloqueo
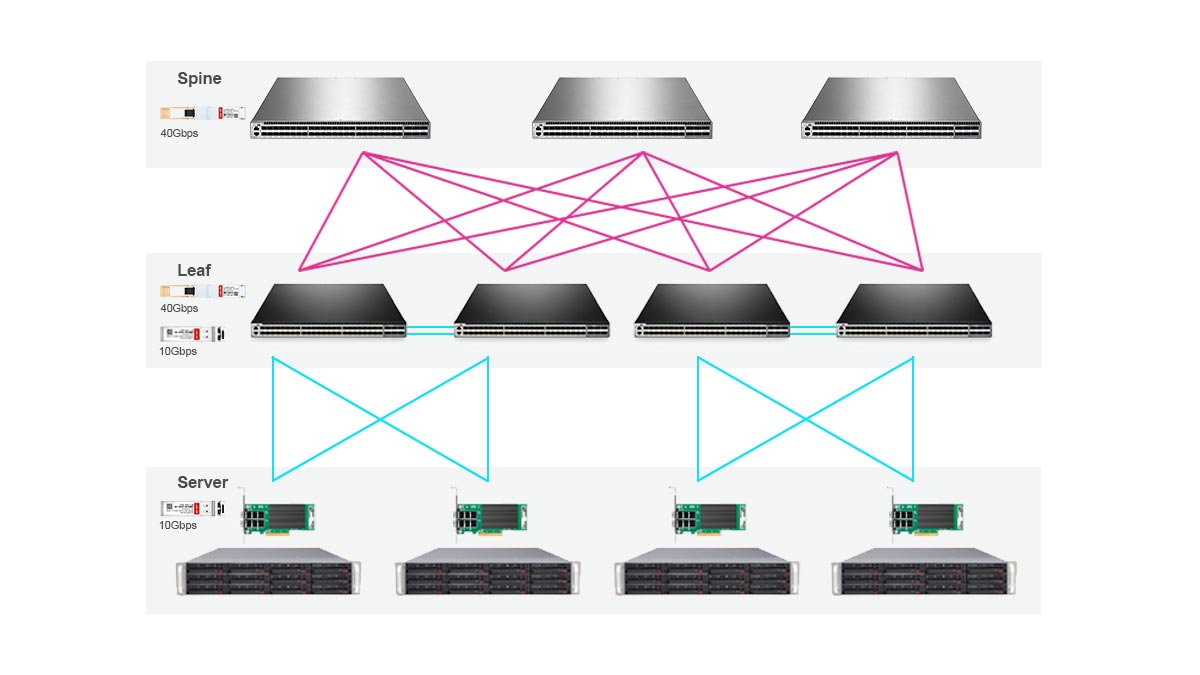
La mayoría de los clústeres de IA utilizan una topología de espina dorsal-hoja porque proporciona una comunicación predecible de baja latencia y un ancho de banda escalable entre los nodos de GPU.
En esta arquitectura:
-
Los conmutadores Leaf se conectan directamente a los servidores GPU.
-
Los conmutadores de columna interconectan todos los conmutadores de hoja.
-
Cada interruptor de hoja tiene rutas de igual coste hacia otras hojas.
Este diseño minimiza los cuellos de botella y admite patrones de tráfico este-oeste de alto ancho de banda, comunes en el entrenamiento de IA.
Los despliegues de IA a gran escala suelen buscar una arquitectura sin bloqueo , donde la red proporcione suficiente ancho de banda para evitar la contención entre nodos durante las operaciones de comunicación de la GPU, como All-Reduce y All-Gather.
Estrategia de sobresuscripción
La sobreasignación se produce cuando el ancho de banda de enlace ascendente disponible es inferior al ancho de banda total orientado al servidor.
Para los clústeres de entrenamiento de IA, es importante mantener una baja sobreasignación, ya que las cargas de trabajo distribuidas de GPU generan tráfico continuo entre nodos. Una alta sobreasignación puede aumentar la latencia y reducir la eficiencia del entrenamiento.
Los enfoques más comunes incluyen:
-
Diseños 1:1 sin bloqueo para grandes clústeres de entrenamiento de IA
-
Bajos índices de sobreasignación para implementaciones de GPU medianas.
-
Mayor sobredemanda para entornos centrados en la inferencia.
La proporción ideal depende del tipo de carga de trabajo, la cantidad de GPU y las limitaciones presupuestarias.
Control de congestión y redes sin pérdidas
Las cargas de trabajo de IA son muy sensibles a la pérdida de paquetes y a la congestión. Incluso pequeñas interrupciones en la red pueden ralentizar el entrenamiento distribuido y dejar las GPU inactivas.
Para mejorar la estabilidad, los tejidos con IA suelen utilizar:
-
Transporte habilitado por RDMA
-
Control de flujo prioritario (PFC)
-
Notificación explícita de congestión (ECN)
Estas tecnologías ayudan a crear un entorno más predecible y de baja latencia para la comunicación de la GPU.
InfiniBand proporciona una gestión de congestión integrada, mientras que las implementaciones de RoCEv2 basadas en Ethernet requieren un ajuste cuidadoso para mantener un comportamiento sin pérdidas.
NCCL, RDMA y ajuste de red
La optimización a nivel de aplicación también es esencial para el rendimiento de las redes de IA.
La biblioteca NVIDIA NCCL (NVIDIA Collective Communications Library) se utiliza ampliamente para la comunicación entre múltiples GPU y depende en gran medida de una transmisión de red eficiente. Una configuración RDMA adecuada ayuda a reducir la carga de la CPU y a mejorar la eficiencia de la transferencia de datos entre GPU.
Las áreas de optimización más comunes incluyen:
-
Ajuste de topología NCCL
-
Configuración de la cola RDMA
-
Afinidad de GPU y alineación NUMA
-
Optimización de MTU
-
Equilibrio de la ruta de tráfico
En conjunto, estas optimizaciones a nivel de red y de aplicación ayudan a reducir la sobrecarga de comunicación y a mejorar la escalabilidad del entrenamiento de IA distribuida.
⭐ Redes de clústeres de IA y módulos ópticos
Los módulos ópticos son un componente fundamental de las redes de clústeres de IA modernas. A medida que los clústeres de GPU crecen de cientos a miles de aceleradores, la red debe ofrecer un ancho de banda extremadamente alto, baja latencia e integridad de señal confiable entre servidores y conmutadores. Esto ha convertido a las interconexiones ópticas de alta velocidad en elementos esenciales para los centros de datos de IA.
Por qué son importantes los módulos ópticos en los tejidos de IA
El entrenamiento distribuido de IA genera un tráfico masivo en dirección este-oeste entre los nodos de GPU. El cableado de cobre por sí solo no puede soportar de manera eficiente la conectividad de 400G y 800G a larga distancia y alta densidad dentro de grandes clústeres de IA.
Los módulos ópticos ayudan a resolver varios desafíos críticos:
-
Comunicación de GPU de alto ancho de banda
-
Transmisión de datos de baja latencia
-
Expansión escalable de tejido de espinas y hojas
-
Reducción de la degradación de la señal a lo largo de la distancia
-
Gestión de cables mejorada en racks de alta densidad
A medida que los clústeres de IA continúan creciendo, las redes ópticas se vuelven cada vez más importantes para mantener un rendimiento estable y una alta utilización de la GPU.
Óptica de 100G, 400G y 800G en clústeres de IA
Las infraestructuras de IA modernas están pasando rápidamente de las redes QSFP28 de 100G a las redes QSFP de 400G y OSFP de 800G.
1. Óptica 100G
Los transceptores de 100G siguen siendo comunes en clústeres de GPU más pequeños, redes de almacenamiento y entornos de IA heredados.
Los casos de uso típicos incluyen:
-
Pequeños clústeres de entrenamiento de IA
-
Redes de inferencia
-
interconexiones de almacenamiento
-
Implementaciones de inteligencia artificial de borde
2. Óptica 400G
La tecnología de 400G se ha convertido en la opción principal para muchas implementaciones de IA empresariales y a hiperescala, ya que proporciona un ancho de banda significativamente mayor para la comunicación distribuida de GPU.
Los módulos ópticos 400G comunes incluyen:
Estos módulos se utilizan ampliamente para la conectividad de la columna vertebral a la hoja y de la hoja al servidor en las arquitecturas de IA modernas.
3. Óptica 800G
Las redes de 800G están emergiendo en los clústeres de IA de próxima generación, diseñados para el entrenamiento de modelos ultragrandes y despliegues de GPU de alta densidad.
Los transceptores 800G OSFP y QSFP-DD800 ayudan a aumentar:
-
rendimiento de la red
-
Densidad de puertos
-
Escalabilidad de la estructura
-
Capacidad de preparación para el futuro
Conectividad QSFP-DD, OSFP y Breakout
En la actualidad, dos formatos principales dominan las redes de IA:
1. QSFP-DD
Los módulos QSFP-DD son ampliamente adoptados porque ofrecen una alta densidad de puertos y una gran compatibilidad con los ecosistemas Ethernet existentes.
Se utilizan comúnmente para:
-
100G
-
200G
-
400G
-
Despliegues 800G
2. OSFP
Los módulos OSFP están diseñados para ofrecer un mayor rendimiento energético y térmico, lo que los hace cada vez más populares en las redes de IA de 800G.
OSFP suele ser la opción preferida en:
-
clústeres de IA a hiperescala
-
Entornos de red de GPU de alta potencia
-
Plataformas de conmutación de ultra alta densidad
3. Opciones de ruptura
La conectividad de división permite que un puerto de alta velocidad se divida en múltiples enlaces de menor velocidad, como por ejemplo:
-
400G a 4×100G
-
800G a 2×400G
-
800G a 8×100G
Los diseños modulares mejoran la flexibilidad y ayudan a optimizar la utilización de los puertos de conmutación en las arquitecturas de IA.
Selección de la óptica para enlaces de clústeres de IA
La selección del módulo óptico depende de la distancia del enlace, los requisitos de ancho de banda, el consumo de energía y la topología de despliegue.
1. Enlaces entre conmutadores
Las conexiones entre la espina dorsal y las hojas generalmente requieren:
-
Mayor ancho de banda
-
Alcance más largo
-
Fibra monomodo para despliegues a gran escala.
En estos casos, se suelen utilizar ópticas de 400G DR4, FR4 y 800G.
2. Enlaces de cambio de servidor
Las conexiones entre el servidor Leaf y la GPU suelen ser más cortas y pueden utilizar:
-
Cables DAC para distancias cortas
-
AOC para alcance medio
-
Óptica multimodo SR para configuraciones de rack flexibles
La elección correcta depende de la densidad del rack y del diseño térmico.
Fibra vs. DAC vs. AOC
|
Tecnología |
Ventajas |
Limitaciones |
Caso de uso típico |
|---|---|---|---|
|
Fibra Óptica |
Gran alcance, alto ancho de banda, escalabilidad. |
Mayor costo |
Telas de hojas de lomo |
|
DAC |
Bajo costo, bajo consumo |
Distancia muy corta |
Conexiones en el mismo rack |
|
Ligero, flexible, mayor alcance que un DAC. |
Coste superior al del DAC |
Enlaces de GPU entre bastidores |
En las redes de clústeres de IA modernas, la mayoría de las implementaciones a gran escala combinan fibra óptica, DAC y AOC para equilibrar el costo, la densidad, la eficiencia energética y la escalabilidad.
⭐ Planificación del ancho de banda para el entrenamiento y la inferencia de IA
La planificación del ancho de banda es fundamental para el diseño de redes de clústeres de IA. Un ancho de banda insuficiente puede reducir la utilización de la GPU, aumentar el tiempo de entrenamiento y generar cuellos de botella por congestión en toda la red. La capacidad de red adecuada depende en gran medida del tipo de carga de trabajo, el tamaño del clúster y los requisitos de escalabilidad futuros.
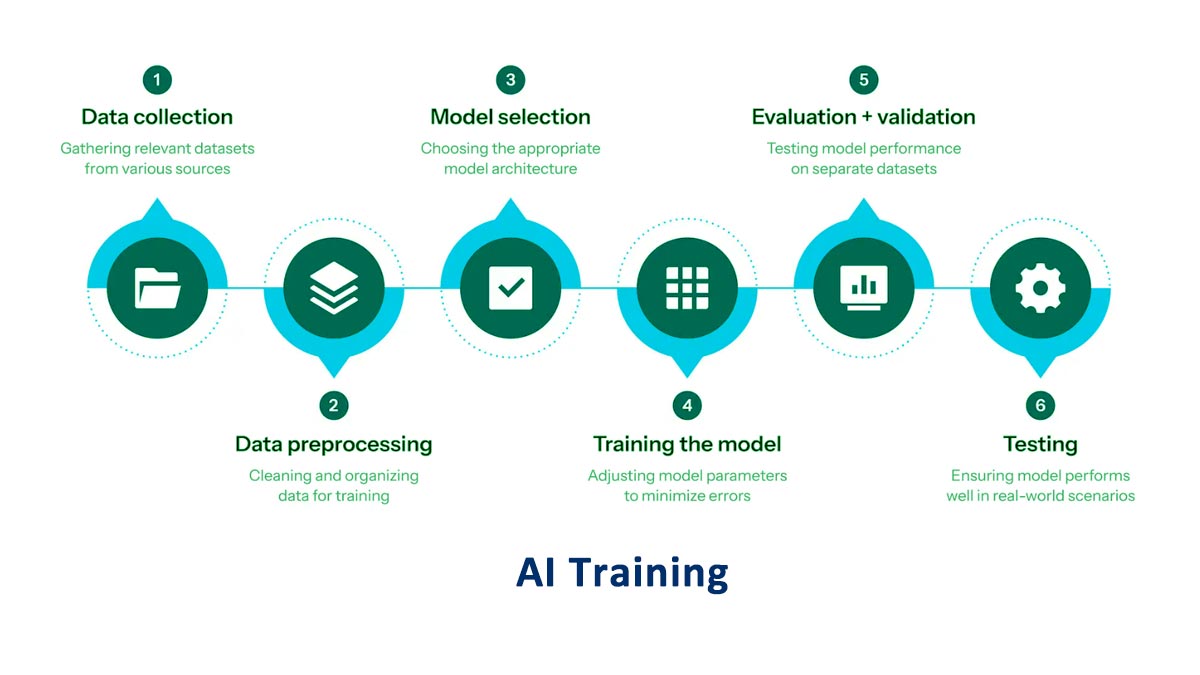
Cómo afecta el tipo de carga de trabajo a la demanda de ancho de banda
Las diferentes cargas de trabajo de IA generan patrones de tráfico muy diferentes.
1. Cargas de trabajo de entrenamiento de IA
El entrenamiento distribuido de IA genera un tráfico este-oeste extremadamente alto debido a que las GPU intercambian constantemente gradientes, tensores y parámetros del modelo durante las operaciones de sincronización.
Los entornos de formación suelen requerir:
-
Rendimiento ultra alto
-
Baja latencia
-
Comunicación habilitada para RDMA
-
Bajos índices de sobredemanda
Los clústeres de entrenamiento de modelos de lenguaje grandes (LLM, por sus siglas en inglés) suelen depender de redes de 400G u 800G para mantener una sincronización eficiente de la GPU.
2. Cargas de trabajo de inferencia de IA
Las cargas de trabajo de inferencia suelen requerir menos ancho de banda porque la comunicación entre nodos es menor.
Las redes de inferencia suelen priorizar:
-
Rápido tiempo de respuesta
-
Escalabilidad de la solicitud
-
Eficiencia de costo
-
Despliegue flexible
En muchos entornos de inferencia, las redes Ethernet de 100G o 400G son suficientes, dependiendo del tamaño del modelo y del volumen de tráfico.
Escalabilidad de nodo único frente a escalabilidad de múltiples nodos
Los requisitos de ancho de banda aumentan significativamente a medida que las cargas de trabajo de IA se extienden a través de múltiples servidores.
1. Sistemas de IA de nodo único
Los servidores GPU de un solo nodo dependen principalmente de interconexiones GPU internas como NVLink o PCIe, lo que reduce la dependencia de redes externas.
Estos entornos suelen requerir un menor ancho de banda de la red.
2. Clústeres de IA multinodo
Las implementaciones multinodo generan un tráfico de red mucho mayor porque las GPU deben sincronizar los datos entre los servidores de forma continua.
A medida que aumenta el tamaño del clúster:
-
El tráfico este-oeste aumenta rápidamente
-
El riesgo de congestión aumenta.
-
Los tejidos de baja latencia se vuelven más importantes.
-
Aumenta la demanda de interconexión óptica.
Los grandes clústeres de entrenamiento distribuidos a menudo requieren arquitecturas spine-leaf de 400G u 800G sin bloqueo.
Planificación para el crecimiento actual y futuro de la IA
Los requisitos de infraestructura de IA están evolucionando rápidamente. Muchas organizaciones que originalmente implementaron redes de 100G ahora están actualizando a 400G y preparándose para la escalabilidad a 800G.
Al planificar tejidos de IA, es importante tener en cuenta lo siguiente:
-
Futura expansión de la GPU
-
Aumento del tamaño de los modelos
-
Mayor densidad de rack
-
Rutas de actualización del módulo óptico
-
Potencia de conmutación y capacidad de refrigeración
Diseñar teniendo en cuenta la escalabilidad futura puede reducir los costosos rediseños de red posteriores.
Reglas prácticas de dimensionamiento para tejidos de IA de 400 g y 800 g
Aunque los requisitos varían según la carga de trabajo, en las redes de IA modernas se suelen utilizar varias directrices prácticas.
1. Redes 100G
Apto para:
-
pequeños clústeres de GPU
-
Entornos de inferencia
-
Sistemas de desarrollo y prueba
2. Redes 400G
Recomendado para:
-
Clústeres de entrenamiento de IA de tamaño mediano a grande
-
Implementaciones de GPU en múltiples racks
-
Tejidos RoCEv2 de alto rendimiento
-
Arquitecturas modernas de hojas y espinas
La tecnología de 400G se ha convertido en la opción predominante para muchos centros de datos de IA empresariales.
3. Redes 800G
Más adecuado para:
-
Infraestructura de IA a hiperescala
-
Formación distribuida a gran escala
-
Tejidos de GPU preparados para el futuro
-
Plataformas de conmutación de IA de alta densidad
Las redes de 800G ayudan a mejorar la escalabilidad, la densidad de puertos y la eficiencia del ancho de banda a largo plazo a medida que las cargas de trabajo de IA continúan expandiéndose.
⭐ Problemas comunes de redes en clústeres de IA y cómo solucionarlos
Incluso los clústeres de IA bien diseñados pueden experimentar problemas de red que reducen la utilización de la GPU y ralentizan el entrenamiento distribuido. Dado que las cargas de trabajo de IA son muy sensibles a la latencia y la congestión, pequeños problemas de red pueden afectar rápidamente el rendimiento general del clúster.
A continuación se presentan algunos de los problemas más comunes de las redes de clústeres de IA y sus soluciones prácticas.
Picos de latencia
Los picos de latencia inesperados pueden interrumpir la sincronización de la GPU y ralentizar las operaciones de comunicación colectiva, como All-Reduce.
Las causas comunes incluyen:
-
Sobrecarga de red
-
Enlaces de hojas y espinas congestionados
-
Políticas de QoS inadecuadas
-
Alta carga de interrupciones de la CPU
-
Distribución desigual del tráfico
Para reducir los picos de latencia:
-
Utilice telas que no bloqueen o que tengan una baja sobreexposición.
-
Habilitar RDMA siempre que sea posible.
-
Optimización del balanceo de carga ECMP
-
Mejorar la alineación de afinidad de GPU y NUMA
-
Monitorear la utilización del búfer del conmutador
Una latencia baja y constante es fundamental para mantener un entrenamiento de IA distribuida eficiente.
Pérdida de paquetes y congestión
La pérdida de paquetes es especialmente perjudicial en los entornos de entrenamiento de IA, ya que las retransmisiones pueden retrasar la sincronización entre miles de GPU.
La congestión suele estar causada por:
-
Tráfico intenso en dirección este-oeste
-
Ancho de banda de enlace ascendente insuficiente
-
Mala gestión de colas
-
Tráfico saturado durante operaciones colectivas
Las soluciones comunes incluyen:
-
Implementación de tecnologías Ethernet sin pérdidas
-
Configurar correctamente PFC y ECN
-
Aumento del ancho de banda del tejido
-
Reducción de los índices de sobredemanda
-
Utilizando mecanismos inteligentes de control de la congestión
Las redes InfiniBand suelen ofrecer una gestión de la congestión integrada, mientras que los entornos RoCEv2 requieren una configuración más precisa.
RDMA o RoCE mal configurados
Una configuración incorrecta de RDMA es una de las causas más comunes de inestabilidad en el rendimiento de las redes de IA.
Los problemas típicos incluyen:
-
Configuración de MTU incorrecta
-
Configuración incorrecta del PFC
-
Configuración incorrecta del DCB
-
Desequilibrio de la cola RDMA
-
Configuración de interruptor incompatible
Los síntomas pueden incluir:
-
inestabilidad en la comunicación de la GPU
-
Bajo rendimiento de NCCL
-
Caídas inesperadas de paquetes
-
Alta latencia durante el entrenamiento distribuido
Para mejorar la estabilidad de RDMA:
-
Estandarizar la configuración de red en todo el clúster.
-
Validar el comportamiento de PFC y ECN
-
Utilice ajustes de MTU consistentes.
-
Pruebe el rendimiento de RDMA periódicamente.
-
Supervisar la eficiencia de las comunicaciones de NCCL
Problemas de incompatibilidad entre controladores y firmware
Los clústeres de IA dependen en gran medida de la compatibilidad entre las tarjetas de red, los conmutadores, las GPU y los sistemas operativos. Las incompatibilidades de firmware pueden generar problemas de rendimiento impredecibles o fallos de RDMA.
Las áreas problemáticas más comunes incluyen:
-
Inconsistencias en el firmware de la tarjeta de red
-
Incompatibilidad del software del conmutador
-
Desajustes en los controladores de la GPU
-
Versiones de funciones RDMA no compatibles
Las mejores prácticas incluyen:
-
Mantener las versiones de firmware estandarizadas en todo el clúster.
-
Validar la compatibilidad antes de las actualizaciones.
-
Mantener líneas base de software documentadas
-
Primero, pruebe las actualizaciones en entornos de prueba.
Una gestión coherente del firmware es esencial para el correcto funcionamiento de las operaciones de IA a gran escala.
Escasa utilización de enlaces en todo el clúster
Algunos clústeres de IA experimentan un uso desigual del ancho de banda, donde ciertos enlaces se congestionan mientras que otros permanecen infrautilizados.
Esto suele ser causado por:
-
Hashing ECMP ineficiente
-
Diseño de topología deficiente
-
Puntos críticos de tráfico
-
Rutas de comunicación desequilibradas de la GPU
Para mejorar la utilización de la tela:
-
Optimizar el diseño de la topología espina-hoja
-
Políticas de ajuste de ECMP
-
Equilibrar las rutas de tráfico a través de los conmutadores
-
Supervise continuamente la distribución del flujo.
-
Utilice herramientas de telemetría y análisis de la estructura
La utilización eficiente del enlace ayuda a maximizar el ancho de banda disponible y a mejorar la escalabilidad general del entrenamiento de la IA.
⭐ Preguntas frecuentes sobre redes de clústeres de IA
P1: ¿Cuál es la mejor red para un clúster de IA?
La mejor red para un clúster de IA depende de la escala de la carga de trabajo, los requisitos de latencia y el presupuesto. Los entornos de entrenamiento de IA distribuidos a gran escala suelen usar InfiniBand debido a su latencia ultrabaja y su excelente rendimiento RDMA. Las implementaciones de IA empresariales suelen optar por RoCEv2 sobre Ethernet para lograr un equilibrio entre escalabilidad, costo y flexibilidad operativa.
P2: ¿Es InfiniBand mejor que RoCEv2?
InfiniBand generalmente ofrece menor latencia y una gestión de congestión más avanzada para clústeres de entrenamiento de IA a hiperescala. Sin embargo, RoCEv2 se ha convertido en una alternativa popular porque combina el rendimiento de RDMA con la infraestructura Ethernet estándar, lo que reduce los costos de implementación y mejora la compatibilidad con las redes empresariales.
Para muchas organizaciones, RoCEv2 ofrece el mejor equilibrio entre rendimiento y escalabilidad.
P3: ¿Los clústeres de IA necesitan óptica de 400G u 800G?
Los clústeres de entrenamiento de IA modernos dependen cada vez más de módulos ópticos de 400G y 800G para admitir la comunicación de GPU de alto ancho de banda.
-
Actualmente, la óptica de 400G es habitual en implementaciones de IA de tamaño mediano a grande.
-
Los componentes ópticos de 800G se utilizan principalmente en redes de IA de hiperescala y de próxima generación.
Los clústeres de inferencia y los entornos de desarrollo más pequeños aún pueden funcionar de manera eficiente con redes de 100G.
P4: ¿Puede Ethernet gestionar el entrenamiento de IA?
Sí. Las redes Ethernet modernas, combinadas con las tecnologías RoCEv2 y RDMA, permiten un entrenamiento de IA a gran escala eficaz. Muchos centros de datos de IA empresariales utilizan ahora Ethernet de alta velocidad con configuraciones de red sin pérdidas para cargas de trabajo de GPU distribuidas.
Sin embargo, las arquitecturas de IA basadas en Ethernet requieren un ajuste cuidadoso de tecnologías como:
-
PFC (Control de flujo prioritario)
-
ECN (Notificación explícita de congestión)
-
DCB (Puente de centro de datos)
Sin una configuración adecuada, la congestión y la pérdida de paquetes pueden reducir la eficiencia del entrenamiento.
P5: ¿Cómo afectan los módulos ópticos al rendimiento del clúster de IA?
Los módulos ópticos influyen directamente en el ancho de banda, la latencia, la escalabilidad y la fiabilidad de la señal en las redes de clústeres de IA.
Los transceptores de alta velocidad, como los módulos QSFP-DD y OSFP, permiten:
-
Conectividad 400G y 800G
-
Comunicación de larga distancia entre espinas y hojas
-
Tejidos de GPU de alta densidad
-
Menor degradación de la señal
-
Mayor escalabilidad para cargas de trabajo de IA distribuidas.
Elegir la óptica adecuada para los enlaces entre conmutadores y entre conmutadores y servidores ayuda a mejorar el rendimiento general del clúster de IA y su escalabilidad futura.
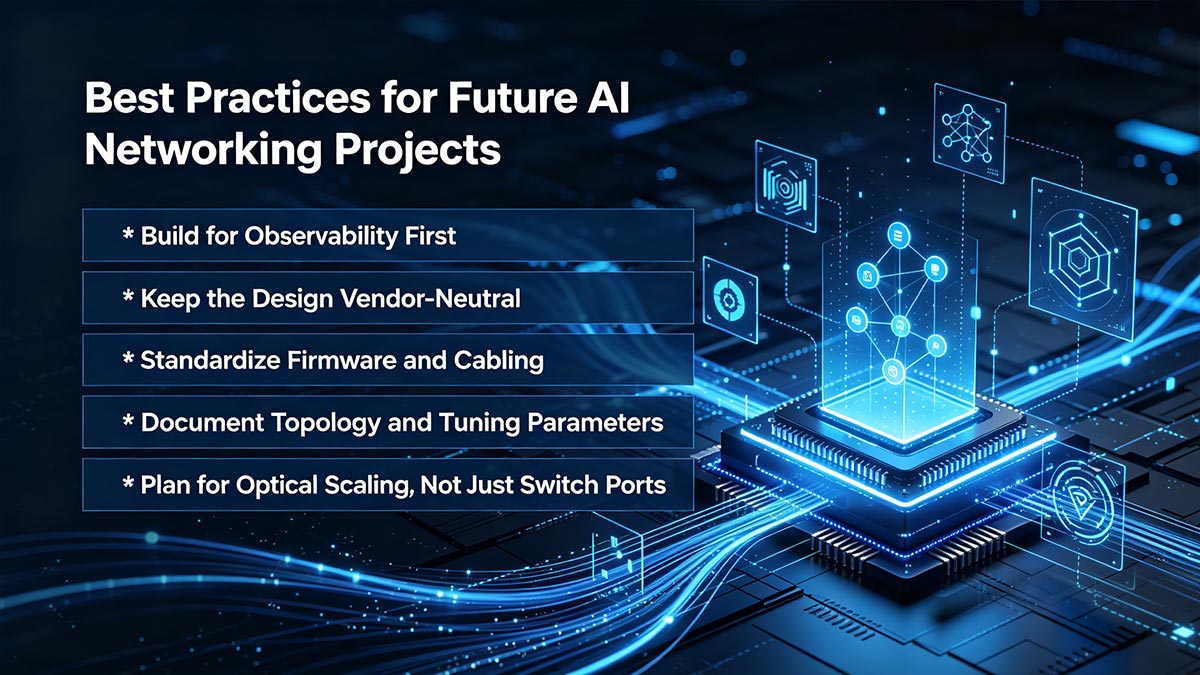
⭐ Mejores prácticas para futuros proyectos de redes de IA
A medida que la infraestructura de IA avanza hacia clústeres de GPU más grandes y redes de 400G/800G, las decisiones de diseño de red que se tomen hoy afectarán directamente la escalabilidad a largo plazo, la estabilidad operativa y el costo de implementación. Los proyectos exitosos de redes para clústeres de IA ya no se centran únicamente en el ancho de banda bruto, sino que también priorizan la observabilidad, la interoperabilidad y la escalabilidad óptica futura.
Diseñar pensando primero en la observabilidad
Los clústeres de IA generan enormes cantidades de tráfico este-oeste, lo que hace que la visibilidad y la monitorización sean esenciales. Las arquitecturas de IA modernas deberían incluir:
-
Telemetría en tiempo real
-
Monitoreo de la congestión
-
Análisis del rendimiento de RDMA
-
visibilidad de la comunicación de la GPU
-
Diagnóstico de conmutadores y sistemas ópticos
La detección temprana ayuda a identificar cuellos de botella antes de que afecten la utilización de la GPU y la eficiencia del entrenamiento.
Mantén el diseño neutral respecto al proveedor.
La dependencia de un único proveedor puede limitar la escalabilidad futura y aumentar los costos de infraestructura. Siempre que sea posible, las organizaciones deberían diseñar sus redes de IA basándose en estándares Ethernet abiertos, óptica interoperable y arquitecturas de interconexión flexibles.
Una estrategia neutral respecto a los proveedores mejora:
-
Flexibilidad de hardware
-
Opciones de actualización
-
Control de costes a largo plazo
-
Compatibilidad con múltiples proveedores
Estandarizar el firmware y el cableado.
Las inconsistencias del firmware son una de las causas más comunes de inestabilidad en las redes de IA. La estandarización del firmware de las tarjetas de red, el software de los conmutadores, los módulos ópticos y los tipos de cables ayuda a reducir los problemas de interoperabilidad inesperados.
Las mejores prácticas incluyen:
-
Mantener versiones de firmware consistentes
-
Utilizando listas de compatibilidad óptica validadas
-
Estandarización del despliegue de DAC, AOC y fibra
-
Pruebas de las actualizaciones antes de su lanzamiento en producción.
Topología del documento y parámetros de ajuste
Las grandes redes de IA pueden llegar a ser extremadamente complejas. Una documentación adecuada simplifica la resolución de problemas y la expansión futura.
Entre los elementos importantes que se deben documentar se incluyen:
-
Diseño de topología de hoja espinosa
-
Configuración de RDMA y RoCE
-
Políticas de ECMP
-
Tasas de sobresuscripción
-
Planes de despliegue de módulos ópticos
-
Parámetros de ajuste de NCCL
Los entornos bien documentados son más fáciles de escalar y mantener a lo largo del tiempo.
Planifique la escalabilidad óptica, no solo los puertos de conmutación.
El futuro crecimiento de la IA requerirá mucho más que puertos de conmutación adicionales. La densidad del ancho de banda óptico, la eficiencia energética y la gestión del cableado se están convirtiendo en factores de diseño igualmente importantes.
Las organizaciones que implementan nueva infraestructura de IA ya deberían estar preparándose para:
-
Rutas de migración de 400G a 800G
-
Mayor densidad de rack
-
Adopción de OSFP y QSFP-DD 800G
-
Infraestructura de fibra escalable
-
Arquitecturas de ultraclústeres del futuro
Elegir el ecosistema óptico adecuado desde el principio puede reducir significativamente la complejidad de las futuras actualizaciones.
A medida que las redes de clústeres de IA continúan evolucionando, las interconexiones ópticas de alta calidad y los componentes Ethernet confiables seguirán siendo fundamentales para una infraestructura de GPU escalable. Para las organizaciones que planifican arquitecturas de IA modernas, la LINK-PP Tienda Oficial Ofrece una amplia gama de módulos ópticos de alta velocidad, soluciones DAC/AOC y productos de conectividad de red diseñados para implementaciones en IA empresarial, HPC y centros de datos.