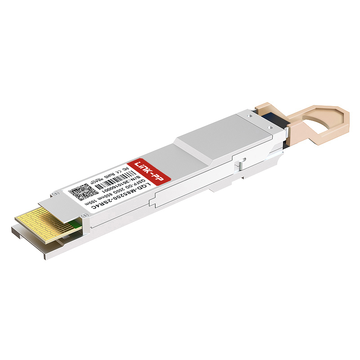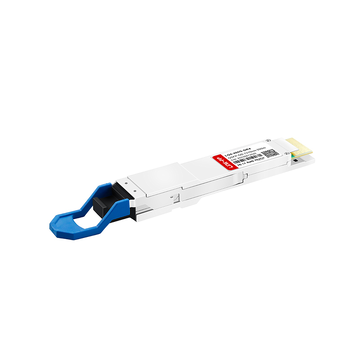




データセンターのラックにスイッチスロットが不足し、帯域幅の需要が急増していませんか?AIクラスターやクラウドコンピューティングといった最新のワークロードが拡大するにつれ、高密度環境では高価なハードウェアを追加することなく、よりスマートな拡張方法が緊急に求められています。QDD-2×100-SR4-S光トランシーバーを統合することで、ポート効率を最大化し、インフラコストを削減できるため、直接的な解決策となります。
追加のスイッチシャーシを購入したり、ラックのスペースを増やしたりすることなく、100Gリンクの密度を倍増させる方法をお探しですか?その答えは、従来のシングルポート光モジュールを高密度光ブレークアウトアーキテクチャに置き換えることにあります。1つの大容量ポートを2つの独立したチャネルに分割することで、ネットワーク設計者はスループットを最適化し、エアフローを改善し、全体的な消費電力を削減できます。
✳️ QDD-2×100-SR4-Sトランシーバーとは何か、そしてどのように動作するのか
現代のデータセンターネットワークでは、増大し続けるトラフィック量に対応するため、超高密度な相互接続が求められています。QDD-2×100-SR4-S光トランシーバーは、2つの独立した100G光インターフェースを1つの物理スイッチスロットに統合することで、ポート密度を実質的に2倍に高め、この課題を解決します。内部動作を詳しく見てみると、これらの高密度モジュールが、シンプルなブレークアウトケーブルによって既存のMPO-12光ファイバーケーブルとの互換性を維持しながら、ポート効率を最大限に高めていることがわかります。
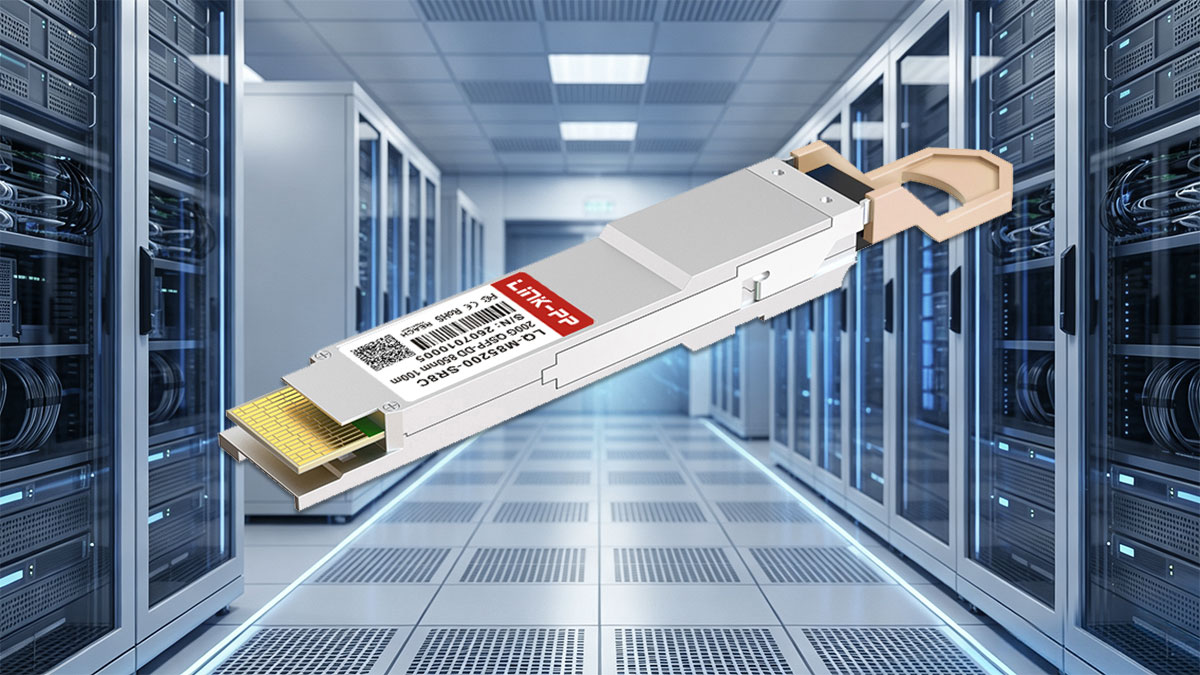
基本的な定義と、デュアル100Gリンクが単一のQSFP-DDポートにどのように収まるか
QDD-2×100-SR4-Sは、2つの完全に独立した100G NRZチャネルを介して合計200Gのスループットを実現するように設計されたQSFP-DD(Quad Small Form-Factor Pluggable Double Density)光モジュールです。QSFP-DDフォームファクタの8レーン電気インターフェースを活用することで、このモジュールは各100Gチャネルに25Gbpsの電気レーンを4つ割り当て、従来のフォームファクタと比較してポート密度を実質的に2倍に高めています。
モジュール内部では、統合された光エンジンが2つの並列100G SR4光ストリームを並行して処理します。スイッチハードウェアはこれらのストリームを2つの独立した論理インターフェースとして認識するため、単一の物理スイッチスロットで、信号のリタイミングのみを行う内部回路を介して、直接並列光伝送によるデュアル100Gリンクを駆動できます。
主な技術仕様:光ファイバーの種類、伝送距離制限、コネクタ
QDD-2×100-SR4-Sモジュールを導入するには、高密度マルチモード光伝送路全体で最適な信号品質を確保するために、物理層のパラメータを厳密に遵守する必要があります。
物理層の動作を規定する主要な技術仕様は以下のとおりです。
- フォームファクター:8レーンの電気インターフェースを備えた標準QSFP-DD。
- 波長:850nm VCSEL送信機をパラレルマルチモードファイバーで伝送。
- 光コネクタ:MPO-24コネクタが前面パネルに一体化されています。
- 伝送距離:OM3 MMFでは最大70m、OM4 MMFでは最大100m。
- データレート:合計200G(1チャネルあたり103.125Gbpsの2×100G NRZとして構成)。
- 消費電力:最適化されたエネルギー設計により、消費電力は4.5W未満です。
200Gから2×100G光ブレークアウトの概念を理解する
光ブレークアウトアーキテクチャは、マルチチャネルトランシーバーの内部データパスを独立したネットワーク接続に分離します。QDD-2×100-SR4-Sトランシーバーは、2×100G-SR4ブレークアウト設計を採用しており、24ファイバーMPOインターフェースを使用しています。このインターフェースでは、16本のアクティブファイバーが2つの独立した8ファイバーセット(100Gリンクあたり4本の送信ファイバーと4本の受信ファイバー)に分割されます。
MPO-24-2×MPO-12ハーネスケーブルをモジュールの前面パネルに直接接続することで、エンジニアは各8ファイバー100Gチャネルを個別のスイッチ、パッチパネル、またはサーバーノードに容易にルーティングできます。この物理的な分岐方式により、遅延や光信号の劣化を招くことなく、短距離でも信号の明瞭さを維持できます。
標準的なネイティブ100G QSFP28 SR4モジュールとの比較
QDD-2×100-SR4-Sを従来のネイティブ100G QSFP28 SR4モジュールと比較評価すると、密度、ケーブル接続方法、チャネルあたりの電力効率に明確な違いが見られます。
両トランシーバーの設計を並べて比較することで、企業における導入シナリオにおいて、これら2つのトランシーバー設計がどのように異なるかが明らかになります。
| 仕様パラメータ | QDD-2×100-SR4-Sモジュール | 100G QSFP28 SR4モジュール |
| フォームファクター | QSFP-DD | QSFP28 |
| モジュール全体の処理能力 | 200G(100Gチャネル×2) | 100G(シングルチャンネル) |
| 電気的インターフェース | 8レーン(1レーンあたり25Gbps NRZ) | 4レーン(1レーンあたり25Gbps NRZ) |
| 光コネクタの種類 | シングルMPO-24 | シングルMPO-12 |
| 理論上の港湾密度 | 最大64×100Gリンク(すべてのポートがブレークアウトモードをサポートしている場合) | 32×100Gリンク(ネイティブ、ブレークアウトなし) |
| 最大消費電力 | <4.5W | <2.5W |
| ケーブル配線アーキテクチャ | MPO-24 - 2×MPO-12 ブレークアウトケーブル | シングルMPO-12ポイントツーポイントケーブル |
標準のQSFP28 100G-SR4モジュールは、1つの100G接続に1つのスイッチポートを占有しますが、QDD-2×100-SR4-Sは、スイッチハードウェアがブレークアウトをサポートしていれば、物理スロットあたりの100Gリンク数を2倍にすることができます。消費電力はわずかに削減されますが(2つの個別のQSFP28モジュールと比較してデュアルリンクあたり約10%)、運用コストと熱負荷が軽減されます。しかし、主な利点は、エネルギー効率の飛躍的な向上というよりも、ポート密度の最適化にあります。
✳️ 高密度データセンターネットワークにQDD-2×100-SR4-Sを使用する理由
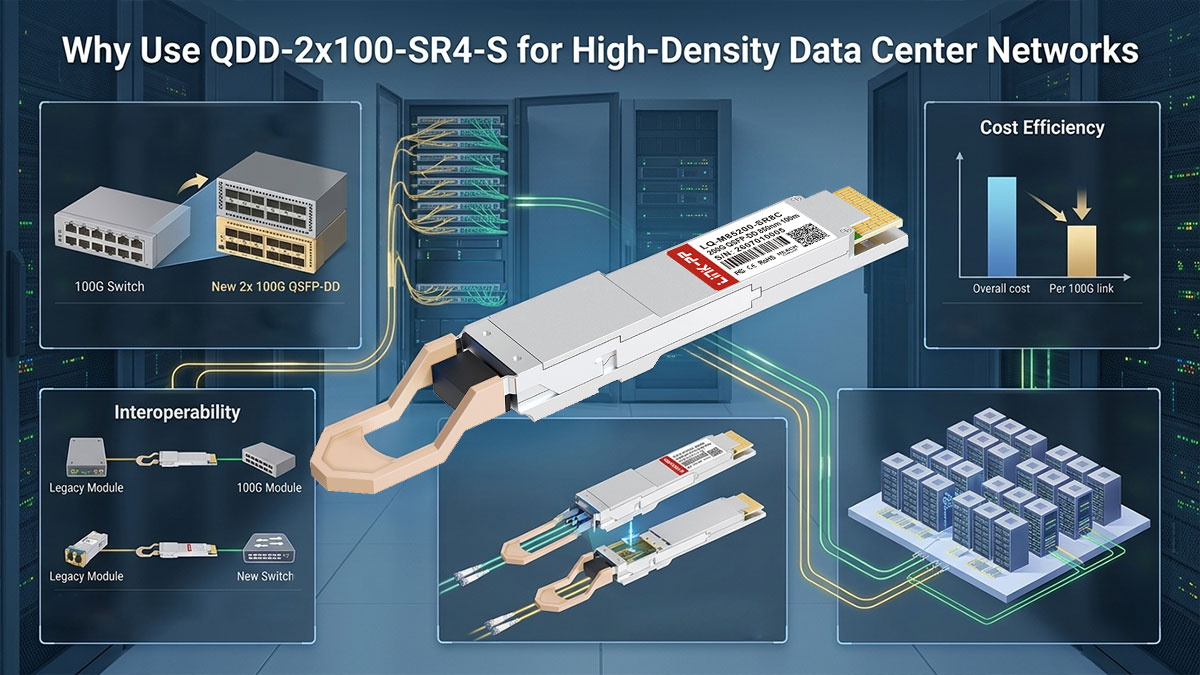
急速に拡大するクラウドサービスと帯域幅を大量に消費するアプリケーションにより、最新のデータセンターはラックのあらゆるスペースを最大限に活用する必要に迫られています。高密度光トランシーバーを導入することで、既存のスイッチインフラストラクチャを通じてより高い帯域幅を実現し、重要な物理的ボトルネックを解消できます。2×100Gブレークアウトアーキテクチャを活用することで、ネットワーク事業者は設備投資と運用パフォーマンスを最適化しながら、スループットを拡張するための明確な道筋を得ることができます。
1つのスイッチポートから合計200Gのスループットを実現する
QDD-2×100-SR4-S光モジュールを採用する主な理由は、単一のQSFP-DDスイッチインターフェースから合計200Gの集約帯域幅を引き出すことができる点にある。従来の構成では、同等のスループットを実現するために2つの独立したQSFP28ポートが必要となり、高密度スイッチの前面パネルのスロットスペースをすぐに使い果たしてしまう。
8レーン25Gbpsの電気ホストインターフェースを2つの独立した100G NRZ論理リンクに分割することで、1つのポートが2つの異なるネットワークチャネルとして機能します。この設計により、スイッチポートの実効密度が2倍になり、ネットワーク設計者は物理的なスイッチ設置面積を拡大することなく、ファブリック全体の帯域幅を拡張できます。
ポート密度を高めることでスイッチ拡張を延期する
QDD-2×100-SR4-Sは、トランシーバー1個あたりの購入コストを削減するものではありません。実際、単体のQSFP28 SR4モジュール2個よりも高価です。真の設備投資上のメリットは、ポートの統合にあります。物理スロットごとに2つの100Gリンクを提供することで、データセンターは既存のスイッチシャーシ内でより多くの100G接続をサポートできるようになります。
この高密度化により、トラフィックの増加に伴う追加のスイッチラインカードやシャーシ全体の調達を延期または回避できるため、ホストプラットフォームがブレイクアウト動作をサポートしている限り、ファブリック容量を拡張する際に戦略的な設備投資上のメリットが得られます。
ラック全体で100Gチャネルあたりの消費電力を削減する
高密度ラック環境においては、熱放散がハードウェア性能を制限するため、エネルギー効率は依然として重要な運用上の優先事項です。光モジュールを統合しても消費電力は完全には解消されませんが、単一のデュアルチャネルモジュールを使用することで、複数の個別のトランシーバーを使用する場合と比較して、顕著なエネルギー節約効果が得られます。
QDD-2×100-SR4-Sモジュールの消費電力は4.5W未満であり、これはアクティブな100Gリンクあたり2.25W未満に相当します。それぞれ最大2.5Wを消費する標準的な100G QSFP28モジュールを2つ使用する場合と比較すると、この構成では100Gチャネルあたり約10%の電力削減が実現され、ラック全体の発熱量をわずかに低減できます。
スイッチ背面のケーブルの乱雑さを軽減し、通気性を向上させる
高密度パッチパネルでは、ケーブルの混雑が深刻化することが多く、サーバーラック背面のホットアイルおよびコールドアイルの熱換気が阻害されます。個々のポイントツーポイント光ファイバーパッチコードが密集した束を管理することは、日常的なメンテナンスを複雑にし、光ファイバーの偶発的な曲がりのリスクを高めます。
QDD-2×100-SR4-Sと構造化MPO-24ブレークアウトケーブルを使用することで、物理的なケーブル配線を大幅に効率化できます。2つの100G光ストリームを1つのトランク接続に統合することで、スイッチ背後のケーブル総量を削減し、ファン排気経路を確保して高密度ラック全体の冷却効率を向上させます。
✳️ QDD-2×100-SR4-Sはリーフ・スパインスイッチの接続性をどのように改善するのか
最新のデータセンターファブリックは、膨大な量の東西データトラフィックを処理するために、ノンブロッキング型のリーフスパインアーキテクチャに大きく依存しています。高密度ブレークアウト光モジュールを統合することで、ネットワークアーキテクトは物理的なスイッチスロットを追加することなく、アップリンクとダウンリンクの帯域幅を拡張できます。QDD-2×100-SR4-Sトランシーバーを導入することで、ポートあたりの物理リンク可用性を2倍にし、スイッチ間の接続を効率化することで、ファブリック相互接続を最適化できます。
スイッチスロットを追加せずにスイッチ間容量を倍増させる
リーフスイッチを中央スパインスイッチに接続するには、ノンブロッキングファブリック比率を維持するために高密度アップリンク集約が必要です。標準的な100G QSFP28モジュールはスパインスイッチの利用可能なシャーシスロットをすぐに消費してしまうため、企業は追加のラインカードや上位機種のスイッチを購入せざるを得なくなります。
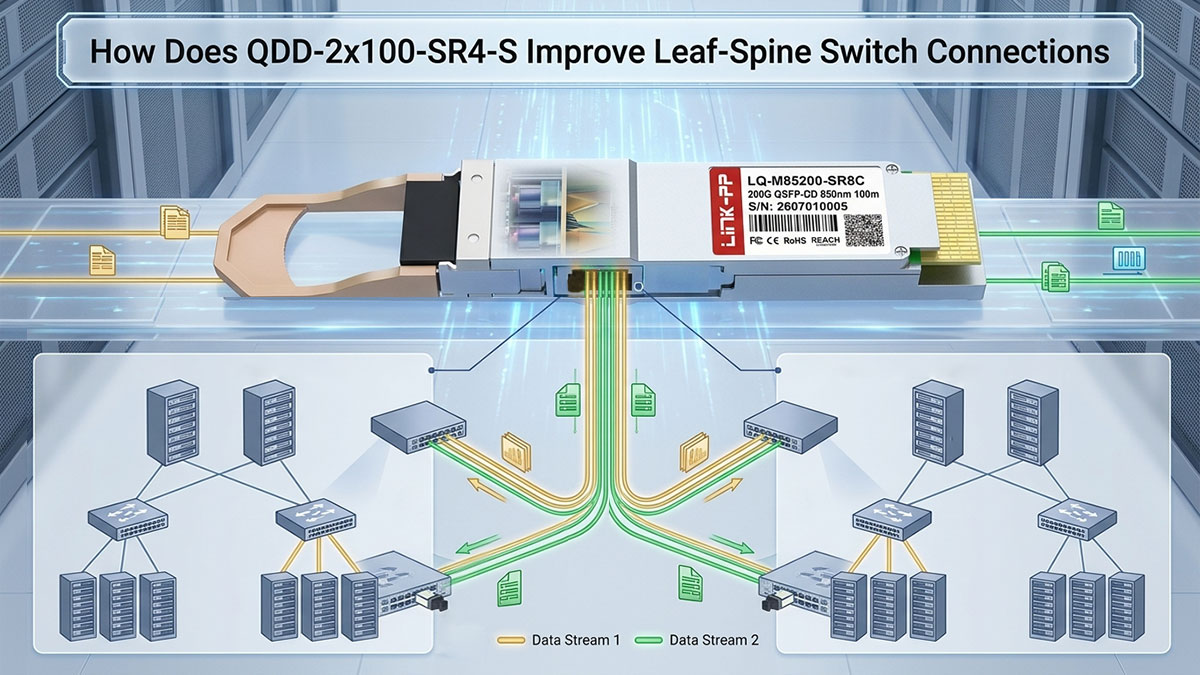
QDD-2×100-SR4-S光モジュールを導入することで、スパインスイッチ上の単一のQSFP-DDスロットから2つの独立した100G NRZリンクを提供できます。このブレークアウト機能により、物理ポートあたりのスイッチ間光伝送容量が実質的に2倍になり、ネットワークエンジニアはコアスイッチ上の貴重なスロットスペースを節約しながら、リーフスイッチとスパインスイッチ間の帯域幅を拡張できます。
サーバー間トラフィックを高速化するためのポート輻輳の解消
最新のクラウドアプリケーションやマイクロサービスは、データセンターのラック間における高速なサーバー間(東西方向)通信に依存しています。リーフからスパインへのアップリンクでポートの過剰利用が発生すると、パケットバッファリングによってレイテンシが増加し、スループットのボトルネックが生じます。
QDD-2×100-SR4-S光モジュールを活用することで、物理ポートあたりの論理アップリンク数を増やすことができます。これにより、ファブリックの絶対的な二区間帯域幅(スイッチASICとポート総数によって制限される)は増加しませんが、利用可能な容量全体にわたるトラフィック分散が大幅に改善されます。
東西交通路全体で達成された主なパフォーマンス改善点は以下のとおりです。
- ECMPハッシュ分散の改善:論理リンクが増えることでフロー衝突の可能性が低減され、利用可能なすべてのアップリンクの利用効率が向上します。
- マイクロバースト輻輳の軽減:トラフィックを2つの100Gチャネルに分散することで、トラフィックの急増時に論理インターフェースごとの瞬間的なバッファ占有率が低下します。
- レイテンシージッターの最小化:リンクごとのキュー深度を低くすることで、分散ノード全体でマイクロサービス呼び出しの伝送遅延を一定に保ちます。
- ノンブロッキングスループット:ファブリック全体が過剰に利用されていない限り、パケットをドロップすることなく、サーバーラック間でラインレートのパフォーマンスを維持します。
1つのスパインスイッチポートを2つのリーフスイッチにきれいに接続する
従来のネットワーク構築では、スパインスイッチを2つのリーフスイッチに接続するには、専用のトランシーバーモジュール2個とスイッチポート2個が必要です。このような物理的な構成では、多数のリーフノードを相互接続する際に、スパインスイッチの前面パネルポートがすぐに不足してしまいます。
QDD-2×100-SR4-Sトランシーバーを使用すると、スパインスイッチ上の単一のQSFP-DDポートから、MPO-24-2×MPO-12ブレークアウトハーネスケーブルを介して、2つの独立したリーフスイッチへスムーズに配線できます。各独立した100G光チャネルはそれぞれ別のリーフスイッチに接続されるため、1:2のスイッチファンアウトが可能になり、構造化配線が簡素化され、ファブリック全体でポート割り当てが最適化されます。
ネットワーク障害を防ぐためのデュアルパス接続の設定
高可用性データセンターファブリックでは、単一障害点(光障害またはハードウェア障害)を防ぐために、耐障害性の高いマルチホーミングトポロジーが必要です。ネットワーク事業者は、稼働時間を維持するために、リーフスパイン接続全体に等コストマルチパス(ECMP)ルーティングとリンクアグリゲーショングループ(LAG)を導入することがよくあります。
QDD-2×100-SR4-Sモジュールのデュアルチャネル設計を利用することで、ネットワーク全体における冗長パスのプロビジョニングが簡素化されます。
耐障害性を実現するための主要なアーキテクチャメカニズムには、以下のものが含まれます。
- デュアルホームアップリンク:1台のリーフスイッチを、それぞれ独立した100G光チャネルを使用して2つの独立したスパインポートに接続します。
- アクティブECMPロードバランシング:東西トラフィックを両方の100Gブレークアウトリンクに均等に分散し、パス効率を最大化します。
- 高速リンクフェイルオーバー:光ファイバーの1本が劣化した場合に、アクティブなセッションを中断することなくトラフィックを再ルーティングし、迅速な収束を保証します。
- ハードウェア分離:各100Gチャネルを独立した論理ポートとして扱い、局所的な障害発生時にリンク全体の損失を防ぎます。
✳️ QDD-2×100-SR4-SがAIや高性能コンピューティングに最適な理由
AIと高性能コンピューティング(HPC)のワークロードは、最新のデータセンターファブリックを物理的な限界まで押し上げ、超低遅延と極めて高い相互接続密度を要求します。分散型GPU処理では、コンピューティングノードがデータ待ちでアイドル状態にならないように、大規模な並列光リンクが不可欠です。QDD-2×100-SR4-Sトランシーバーを導入することで、AIネットワークアーキテクトは、信号の完全性や遅延バジェットを犠牲にすることなく、コンピューティングファブリックとストレージファブリック全体の相互接続密度を2倍にすることができます。
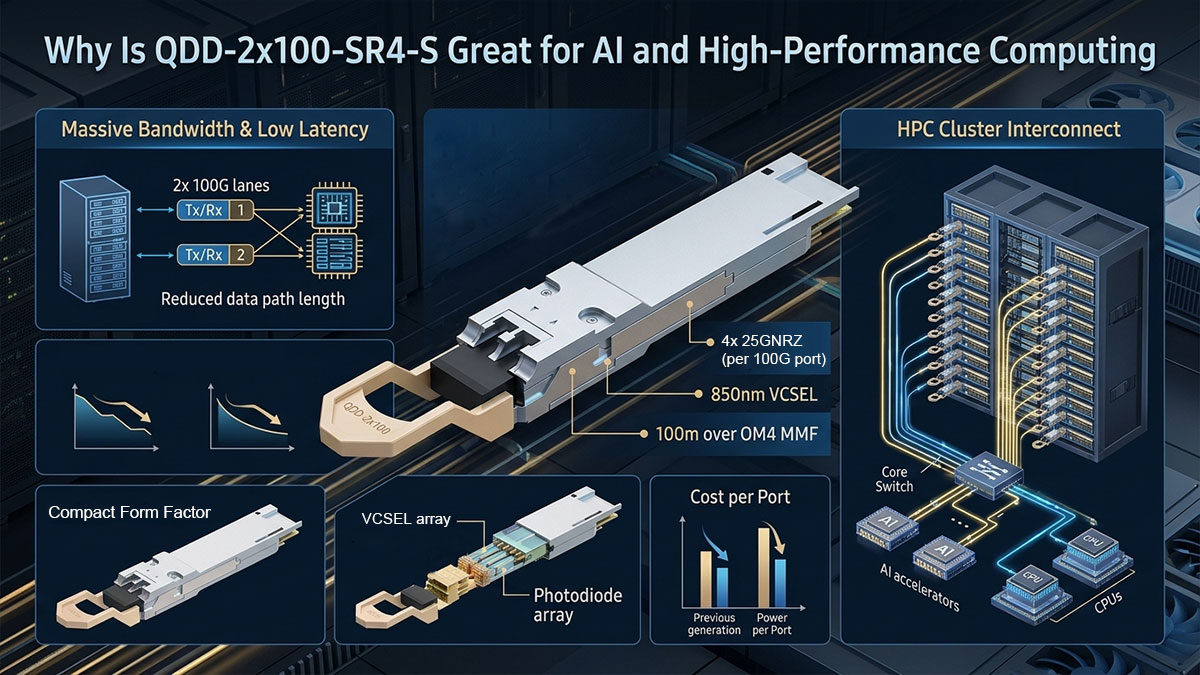
GPUラックをストレージノードに低遅延で直接接続する
高性能AIクラスタでは、NVMeストレージプールからGPUメモリへ、膨大なトレーニングデータセットを低遅延で継続的にストリーミングする必要があります。ネットワークの遅延やジッターが発生すると、高価なアクセラレータへのデータ供給が滞り、モデルのトレーニング時間と運用コストが大幅に増加します。
QDD-2×100-SR4-S光モジュールを使用してストレージアレイを接続することで、複雑なプロトコル変換レイヤーをバイパスした、直接的で多重化されていない100Gパスが確立されます。OM4マルチモードファイバー上で短距離パラレル光伝送を利用することで、光レイヤーの遅延をマイクロ秒未満(短距離で通常約300ナノ秒)に抑え、GPUノードが安定した途切れのないトレーニングデータフローを受信できるようにします。
AIクラスタ向けToRスイッチのポート数を最大化する
AIクラスタにおけるトップオブラック(ToR)スイッチは、高密度GPUサーバーノードを接続する際に、物理ポートがすぐに不足してしまう。従来の100Gインターフェースはフロントパネルのスロットを急速に消費するため、オペレーターは追加のスイッチ層を導入せざるを得ず、ネットワーク遅延とコストが増加する。
2×100Gブレークアウト光モジュールを導入することで、いくつかの重要な物理層の利点を通じてToRスイッチの効率が向上します。
- スイッチあたりの論理インターフェースが2倍に増加:1RUあたり64個の論理100Gインターフェース(32個の物理ポートを分割)を提供します。実際のサーバー数は、ノードごとのNICと冗長性によって異なります。
- 簡素化されたレール最適化配線:最新のGPUサーバーアーキテクチャに典型的なマルチレールネットワークトポロジーに対応します。
- 階層間ホップ数の削減:中間スイッチの集約階層を排除することで、クラスタのレイテンシを一定に保ちます。
- 最適化されたラック空間:貴重なフロントパネルのスロットをアドオンハードウェア用に解放することで、コンピューティング密度を最大化します。
大規模AIモデルのトレーニング中に発生する急激なトラフィック増加への対処
分散型AIモデルのトレーニングでは、AllReduce操作などの勾配交換サイクル中に、大規模で同期的なトラフィックバーストが発生します。ネットワークチャネルに十分な並列帯域幅がない場合、これらのバースト的な通信パターンは、深刻なポートテールドロップとマイクロバースト輻輳を引き起こします。
QDD-2×100-SR4-Sモジュールは、物理スロットごとに2つの独立した100Gハイウェイを提供することで、バーストによるボトルネックを緩和します。独立した100G論理チャネルを異なる演算レールに割り当てることで、トラフィックのクロストークを防ぎ、スイッチが突発的な東西方向のマイクロバーストをより多くの論理リンクに分散させ、個々のキューが飽和する可能性を低減します。
コンピューティングノード全体でのデータ損失とパケットドロップの削減
RoCEv2(RDMA over Converged Ethernet)のようなロスレスイーサネットプロトコルスイートは、AIワークロード実行中のスループットの大幅な低下を防ぐために、パケット損失ゼロを要求します。パケット損失が発生すると再送信が発生し、GPU実行パイプラインが停止するため、クラスタ全体の効率が著しく低下します。
QDD-2×100-SR4-Sトランシーバーを統合することで、重要な光学的および論理的メカニズムを通じて、ロスレスなネットワーク運用を維持することができます。
- 低ビット誤り率:短いマルチモード伝送距離においてクリーンな光信号を維持し、フレームの破損を最小限に抑えます。
- 専用バッファ割り当て:トラフィックを個別の100G論理ポートに分離し、キューのポーズフレームを隔離します。
- PFCデッドロック緩和:バースト的なフローを別々の物理経路に分散させることで、優先フロー制御のデッドロックを軽減します。
- 安定した光出力マージン:VCSEL送信機の出力を一定に保ち、高負荷時におけるリンクの不安定性を防ぎます。
✳️ QDD-2×100-SR4-S ブレークアウトリンクのケーブル配線および展開ガイド
高密度光ブレークアウトリンクの導入には、信号の完全性を維持し、ラックレイアウトをすっきりと保つために、綿密な設備計画が必要です。適切なファイバーの選択、コネクタのアライメント、および構造化されたケーブル配線により、高速リンクが挿入損失の許容範囲を超えずに確実に動作します。確立された光ケーブル配線手順に従うことで、QDD-2×100-SR4-Sトランシーバーを企業およびクラウドデータセンター環境に効率的に設置できます。
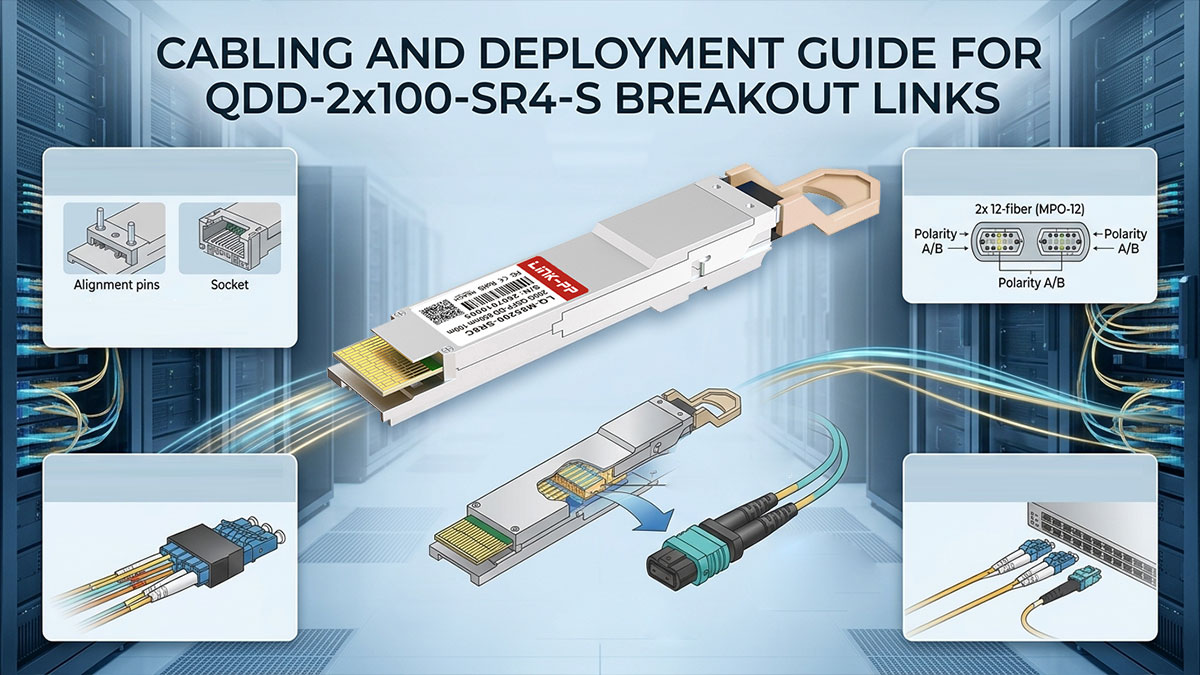
直接リンクにMPO-24から2×MPO-12へのブレークアウトケーブルを使用する
QDD-2×100-SR4-Sトランシーバーは、MPO-24フェースプレートインターフェースを採用しており、200Gの集約容量を2つの独立した100G光ストリームにきれいに分割します。MPO-24から2×MPO-12へのブレークアウトハーネスケーブルをモジュールに直接接続することで、1つのQSFP-DDポートを2つの独立した8ファイバー100Gチャネルに変換できます。
この物理的な分岐構成により、ネットワークエンジニアは、中間的な光変換を行うことなく、各MPO-12ケーブルを個別のターゲットスイッチまたはパッチパネルに直接配線できます。追加のアダプタプレートやアクティブトランスコーダが不要になるため、直接ハーネスリンクは光減衰を最小限に抑えつつ、短距離のポイントツーポイント接続を簡素化します。
OM3/OM4マルチモードファイバーにおける距離制限とリンクバジェット最適化
QDD-2×100-SR4-S光モジュールで信頼性の高いラインレート伝送を実現するには、マルチモードファイバーのグレードを特定の伝送距離要件に適合させる必要があります。並列光経路におけるビット誤り率の低下を防ぐため、総挿入損失はトランシーバーのリンクバジェット内に厳密に収まるようにしなければなりません。
主な物理的距離の閾値と光パワーバジェットに関する考慮事項は以下のとおりです。
- OM3の到達距離制限:最大70mの伝送距離をサポートします。
- OM4到達距離制限:最大伝送距離を100mまで延長します。
- 最大総リンク損失:すべてのコネクタとスプライスを含め、OM3とOM4の両方でエンドツーエンドの減衰を1.9dB未満(IEEE 802.3bm準拠)に維持します。
- コネクタ損失制御:各MPOコネクタの損失を(TIA-568規格に基づき)0.35dB以下に制限し、合計1.9dBの許容範囲内に収まるようにすることで、必要に応じて複数のパッチパネルホップを可能にします。
- モード帯域幅:850nmにおけるモード分散を最小限に抑えるためには、十分な実効モード帯域幅(EMB)を備えた高品質のOM3/OM4ファイバーが必要です。
パッチパネルとMPOトランクケーブルを使用した構造化配線レイアウト
大規模データセンターの導入においては、スイッチ列とサーバーキャビネット間の高密度な光ファイバー配線を整理するために、構造化配線アーキテクチャが用いられます。QDD-2×100-SR4-Sトランシーバーを構造化パッチパネルに統合することで、直接的なポイントツーポイントケーブルの乱雑さを回避しつつ、繊細な光コネクタを保護することができます。
高密度ブレークアウトリンクのための基本的な構造化ケーブル設計原則は以下のとおりです。
- MPOトランクアグリゲーション:高ファイバー数のMPO-24トランクケーブルを、天井トレイまたは床下経路を通して配線します。
- カセット式ブレークアウトパネル:ラックマウント型パッチパネル内部にMPO-24から2×MPO-12への変換カセットを使用することで、配線盤におけるポートマッピングの簡素化とケーブル管理の効率化を実現します。
- タイプB極性アライメント:すべての並列ブレークアウトチャネルにおいて、送信ファイバーと受信ファイバーのマッピングが正しく行われることを保証します。
- 柔軟なパッチング:スイッチシャーシ内のアクティブなQDD-2×100-SR4-Sモジュールに影響を与えることなく、パッチパネルで迅速なリンク再構成を可能にします。
ケーブル管理のベストプラクティス:清潔で保守しやすいラックを実現
高密度スイッチの背後にある物理的なケーブル配線を整然と維持することで、光トランシーバーへの機械的負荷を防ぎ、適切な空気の流れを確保できます。光ファイバーケーブルを最小曲げ半径を超えて曲げると、深刻なマクロベンディング損失が発生し、光パワーレベルが低下し、リンクの不安定化を引き起こします。
QDD-2×100-SR4-Sモジュール用のブレークアウトケーブルを取り付ける際は、技術者はハーネスの脚部を、きついプラスチック製の結束バンドではなく、面ファスナーで固定する必要があります。ラックマネージャー内で垂直ケーブルを適切に支持することで、トランシーバーの前面パネルにかかる張力が軽減され、安定した機械的位置合わせと長期的なリンクの信頼性が確保されます。
✳️ QDD-2×100-SR4-Sのリンクと信号に関する一般的な問題のトラブルシューティング
高密度ブレークアウトリンク全体でラインレートの物理層安定性を維持するには、光インターフェースと論理インターフェースの体系的な診断が必要です。わずかな光ファイバーの汚染やケーブル配線のミスでも、並列光ストリームに悪影響を与え、予期せぬリンク切断を引き起こす可能性があります。構造化された診断手順に従うことで、QDD-2×100-SR4-S環境全体で物理信号障害を迅速に特定し、解決することができます。
光減衰の増大を避けるためのMPOインターフェースの清掃と検査
高密度MPO-24端面に付着した微細な塵や油の汚染は、並列マルチモードリンクにおける光挿入損失の上昇の主な原因です。単一のファイバーのコアが汚れていると、対応するレーンのBERが上昇し、100Gチャネル全体でFECエラーが発生する可能性があるため、接続前にファイバー顕微鏡を使用してすべてのファイバー端面を検査することが非常に重要です。
技術者は、専用の乾式MPOプッシュクリーナーまたはマルチファイバーアレイ専用に設計された糸くずの出ないカセットクリーナーを使用して、コネクタのフェルール面を清掃する必要があります。QDD-2×100-SR4-Sトランシーバーにケーブルを挿入する前に厳格な検査手順を確立することで、永久的な物理的傷を防ぎ、減衰量を1.9dBの許容範囲内に維持できます。
CLIによる光送信電力と受信電力の検証
コマンドラインインターフェイス(CLI)診断ツールを使用すると、モジュールのすべてのアクティブチャネルにおけるデジタル光モニタリング(DOM)メトリックをリアルタイムで確認できます。トランシーバーの状態コマンドを実行することで、ネットワークエンジニアは送信(Tx)および受信(Rx)光パワーレベルが正常な動作しきい値内に収まっているかどうかを確認できます。
特定のチャネルにおける受信電力の急激な低下は、通常、MPOコネクタの汚れ、光ファイバー幹線の微小な曲がり、またはケーブル脚の損傷を示しています。リアルタイムのCLIテレメトリを基準電力仕様と比較することで、リンク全体の障害が発生する前に、劣化している光伝送区間を迅速に特定できます。
リンクフラップ、ビットエラー率(BER)、およびブレークアウトポートマッピングのトラブルシューティング
断続的なリンクフラッピングやビット誤り率(BER)の上昇は、通常、スイッチのオペレーティングシステムと物理層間のポートブレークアウト構成の不一致に起因します。ホストスイッチインターフェイスが明示的に2×100Gブレークアウトモードに設定されていない場合、スイッチASICはホストの電気レーンをQDD-2×100-SR4-Sモジュールのデュアル論理チャネルにマッピングできません。
エンジニアは、インターフェース速度、チャネル設定、および前方誤り訂正(FEC)プロファイルが、接続されているリモートノードで同一のパラメータと一致していることを確認する必要があります。ソフトウェア構成コマンドを物理的なブレークアウトマッピングに合わせることで、フレーミングエラーが解消され、回線速度でのデータ伝送が安定します。
光ファイバーの極性ミスマッチとチャネルアライメントエラーの解決
MPO幹線ケーブルにおいて、光ファイバーの極性マッピングが誤っていると、送信機のVCSELアレイと受信機のフォトダイオードの位置ずれにより、光信号が完全に失われます。2×100Gブレークアウトリンクでは、ケーブルの極性が誤っている(例えば、タイプBではなくタイプAを使用するなど)と、送信機と受信機の光ファイバーマッピングがずれてしまいます。受信機は光を受信しますが、誤ったレーンで受信するため、適切な信号回復が妨げられます。
極性に関する問題のトラブルシューティングでは、エンドツーエンドの光ファイバー経路をたどり、パッチパネルとカセットアダプタ間でキーの向きが適切であることを確認します。Txファイバーレーンが対応するRxチャネルに直接マッピングされていることを確認することで、光パワーの供給が回復し、QDD-2×100-SR4-Sトランシーバの安定したリンクアライメントが再確立されます。
✳️ 高密度ブレークアウトアーキテクチャにおけるQDD-2×100-SR4-Sの導入に関する最終的な考察
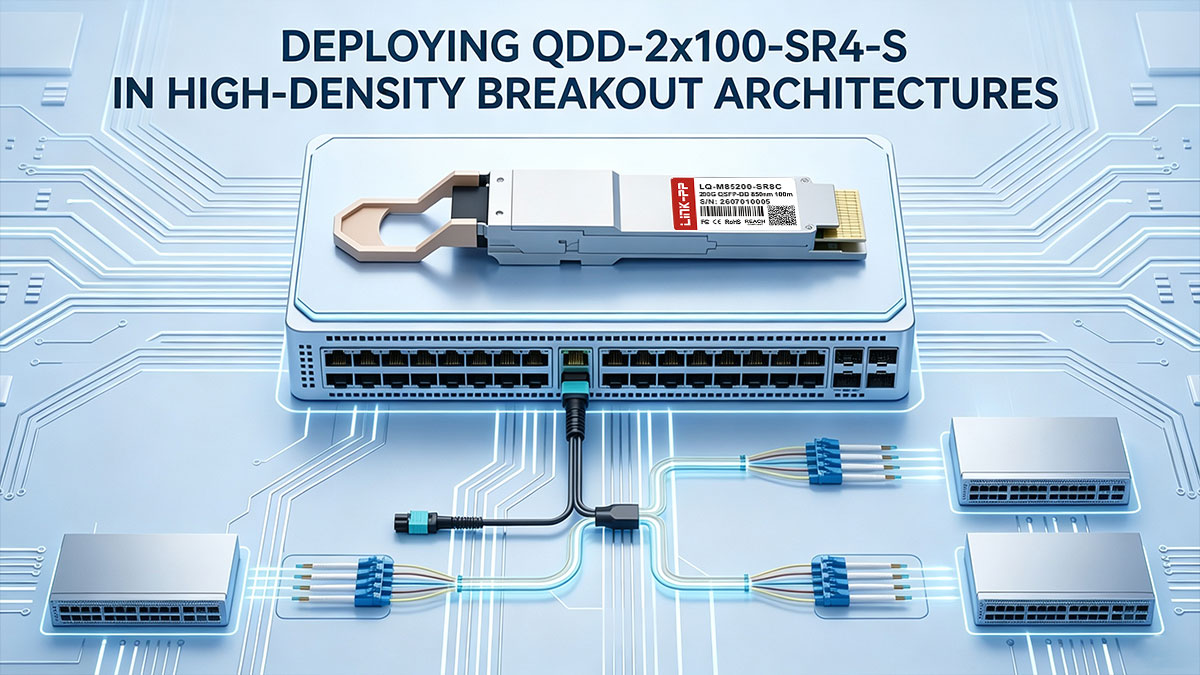
QDD-2×100-SR4-S光トランシーバーの導入は、物理的なスイッチ設置面積を拡大することなくフロントパネルのポート密度を最大化することを目指す最新のデータセンターにとって、非常に効果的な戦略となります。2つの独立した100G NRZストリームを1つのQSFP-DDスロットに統合することで、ネットワーク設計者はリーフスパイン相互接続を最適化し、AIコンピューティングクラスタを高速化し、高額なスイッチシャーシのアップグレードを延期できます。この導入を成功させるには、高精度なMPO-24ブレークアウトケーブル、厳格なエンドフェースクリーニングプロトコル、および互換性のある高性能光モジュールを組み合わせることが不可欠です。
高密度ブレイクアウト展開向けに信頼性が高くコスト効率の良い光モジュールを求める企業ネットワークにとって、高品質のサードパーティ互換トランシーバーはOEMモジュールに代わる理想的な選択肢となります。 LINK-PP LQ-M85200-SR8C 200G QSFP-DD光モジュールは、Cisco QDD-2×100-SR4-S仕様との完全な互換性を備えており、OM3/OM4マルチモードファイバーリンク全体でシームレスなラインレート性能と低遅延を実現します。
高密度ネットワークのアップグレード向けに、徹底的にテストされたエンタープライズグレードの光トランシーバーモジュールについて詳しく知りたい場合は、こちらをご覧ください。 LINK-PP オフィシャルストア 。