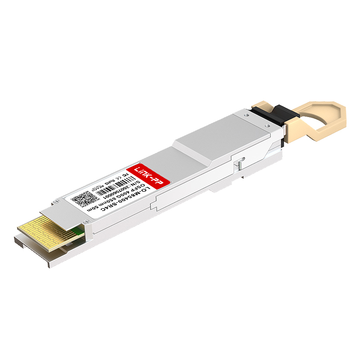





現代のAIデータセンターは、膨大な量のトレーニングデータ、勾配、その他の東西トラフィックを、深刻なボトルネックを発生させることなくGPU間でどのように転送しているのでしょうか?その答えは、 NVIDIA MMA4Z00-NS400のような高性能インターコネクトにあります。これは、超高速かつ低遅延のコンピューティングファブリック向けに設計された400G OSFP SR4光トランシーバーです。AIモデルが急速に拡大するにつれ、この高速モジュールがどのようにして信頼性の高い400Gスループットを維持しているかを理解することが、ネットワークエンジニアにとって不可欠となっています。
このような極めて高速なデータ伝送を可能にするために、トランシーバー内部ではどのような物理プロセスが起こっているのでしょうか?プラグアンドプレイ方式のハードウェアに加え、あらゆる伝送は、高精度な850nm VCSELレーザーのダイナミクス、高度なPAM4変調、マルチモードファイバーの伝送、そして厳密な温度制御に依存しています。これらの光コンポーネントの背後にある物理原理を探ることで、データセンターが負荷の高い状況下でも信号の完全性を維持し、コストのかかる伝送エラーを最小限に抑える方法が明らかになります。
↘️ NVIDIA MMA4Z00-NS400とは何ですか?また、どのように400Gのデータを送信するのですか?
最新のサーバーラック全体で途切れることのないデータフローを実現するには、高密度な物理リンク向けに特別に設計されたハードウェアが必要です。NVIDIA MMA4Z00-NS400は、高速電気入力と低損失光チャネルを組み合わせることで、膨大な帯域幅をリアルタイムで伝送し、このニーズに応えます。
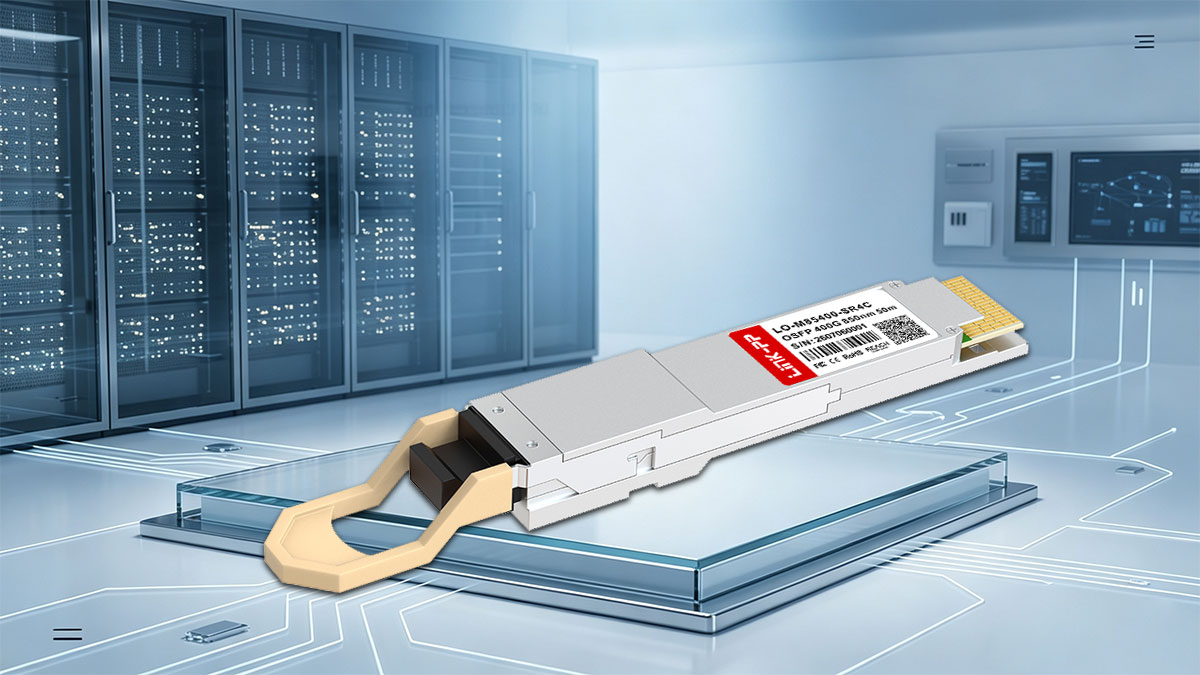
MMA4Z00-NS400 OSFPモジュールの基本概要
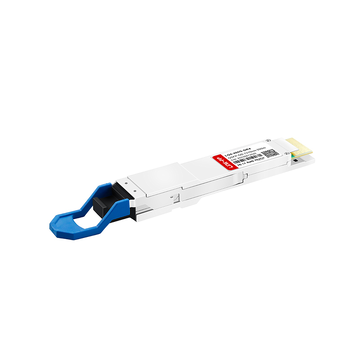
NVIDIA MMA4Z00-NS400は、OSFP(Octal Small Form-factor Pluggable)規格に準拠したプラグイン式光トランシーバーです。主に短距離マルチモードファイバー接続向けに設計されており、隣接するラック内のスイッチやホストアダプタを接続します。このクラスの他のNVIDIAトランシーバーと同じOSFPピン配列を採用しているため、混在構成での導入が容易です。
堅牢な金属製筐体には、レーザードライバー、レシーバー、光学アセンブリが一体化され、コンパクトな筐体に収められています。この自己完結型の構成により、繊細な光学部品を電磁干渉から保護するために必要な構造的な耐久性と電気的シールドが確保されています。
電気信号を高速光パルスに変換する
このモジュールは、電子演算と高速フォトニックネットワークの境界に位置する。ホストボードから高周波電圧変動として送られてくる生のビットデータは、内部のドライバ回路によって解釈される。
これらの回路は、光エミッタアレイに電流を即座に供給し、電気電圧を高速な光パルスに変換します。この電気光学変換により、純銅ケーブルにありがちな高い信号減衰なしに、光ファイバーを介してデータが伝送されます。
4つの並列光チャネルにより400Gの帯域幅を実現
NVIDIA MMA4Z00-NS400は、400Gbpsのデータストリーム全体を単一の光エミッタに通すのではなく、ワークロードを4つの独立した物理レーンに分割します。各レーンは高速100G-PAM4光変調方式を採用し、4つの光レベルと53.125GBdのシンボルレートを組み合わせることで、総データストリームの4分の1を伝送します。
モジュール内部では、統合されたマルチファイバーアレイがこれら4つの光ストリームを業界標準のMPO-12/ APCコネクタへと導きます。並列マルチモードファイバーを介して送受信を同時に行うことで、トランシーバーは400Gのフルラインレート速度を実現しながら、すべてのチャネルで安定した消費電力と安全な熱制限を維持します。
最新のAIネットワーク向け高スループットデータ接続
最新の分散型トレーニング処理では、数千個のGPUが連携して、勾配の即時共有とパラメータの更新が求められます。NVIDIA MMA4Z00-NS400は、InfiniBand NDRや400GbEなどのファブリックに必要な低遅延の光ファイバーを提供し、計算処理の無駄を省きます。
このトランシーバーは、最大50mの距離で安定した400Gリンク性能を維持することで、リーフアンドスパイン型クラスタ構成を最高のスループットで動作させます。スイッチ間のボトルネックを解消し、大規模な計算クラスタが統合された高効率なAIスーパーコンピュータとして機能することを保証します。
↘️ NVIDIA MMA4Z00-NS400内部ではレーザー物理学はどのように機能するのか?
電気信号を4つの並列光ストリームに変換するには、非常に高速で高集束な光光源が必要です。NVIDIA MMA4Z00-NS400では、固体レーザーの物理原理によってこの変換が実現され、短距離の光ファイバーリンクを確実に伝送できる、明るく予測可能な光パルスが生成されます。
850nm VCSELレーザーダイオードの動作と発光
NVIDIA MMA4Z00-NS400光送信機の核となるのは、垂直共振器面発光レーザー(VCSEL)アレイです。チップの端面から横方向に光を照射するエッジ発光レーザーとは異なり、VCSELは半導体表面に対して垂直方向に光ビームを照射します。この特殊なマイクロキャビティ構造により、レーザーは最小限の電力消費で毎秒数十億回もの状態遷移を実現できます。
各ダイオードキャビティ内部での物理的な動作は、一連の精密な半導体特性に依存している。
- 順方向バイアス電圧を印加すると、電子と正孔が微細な量子井戸に注入される。
- 電荷キャリアが再結合すると、共振光キャビティ内で光子が放出される。
- 平行に配置された誘電体ブラッグミラーは、光を反射し合うことで誘導放出を引き起こす。
- コヒーレントな円形光ビームが、850nmの波長で上部の円形開口部から垂直に射出される。
マルチモード光を用いた短距離光伝送
NVIDIA MMA4Z00-NS400では、マルチモードファイバーコアの物理的特性に合わせるため、850nmの波長が意図的に選択されました。この波長の近赤外光子は、短いガラススパンでは材料分散が最小限に抑えられるため、ラック内およびラック間の接続に最適です。
さらに、850nm VCSELから放射される円形出力ビームは、マルチモードファイバーの比較的大きな50ミクロンのコアに効率的に結合します。この高い結合許容度により、複雑で高精度な集光光学系が不要となり、アセンブリを小型かつコスト効率よく構成できます。
レーザービームの安定性と出力電力調整
安定したデータレートを維持するには、光出力の厳密な管理が不可欠です。レーザー電流や温度の変動は光出力に直接影響を与え、高速パルスが光ファイバーに到達する前に歪むリスクがあります。
信号劣化を防ぐため、NVIDIA MMA4Z00-NS400の内部ドライバ回路は、バイアス電流と変調電流をリアルタイムで監視および調整します。内蔵のフォトダイオードセンサーが実際の光出力を継続的に追跡し、長時間のネットワーク負荷時でもレーザービームが安全な校正済み電力範囲内に収まるようにします。
↘️ NVIDIA MMA4Z00-NS400 は PAM4 を使用してデータレートを向上させるにはどうすればよいですか?
超高速でデータを転送する場合、安定したレーザー光を発することは、課題の半分に過ぎません。物理的に制御不可能なレーザー周波数を必要とせずに400Gのラインレートを実現するために、NVIDIA MMA4Z00-NS400はパルス振幅変調(PAM)を採用し、各光パルスにより多くの情報を詰め込んでいます。
データスループットを2倍にする4段階光パルス
NVIDIA MMA4Z00-NS400は、4レベルパルス振幅変調(PAM4)を使用して、4つの光レーンを介してデータを送信します。各内部VCSELは、光を完全にオン/オフするのではなく、00、01、10、11とラベル付けされた4つの異なる光パワー閾値にわたって光を放射します。これらの変化する光強度ステップにより、受信側は単一の測定ウィンドウから2つの異なるビットを判別できます。
各輝度レベルがそれぞれ特定の2ビットバイナリの組み合わせに対応するため、このモジュールはクロックサイクルごとに2倍のデータを送信します。レーンあたり53.125GBdのボーレートで動作するこの4レベル機構により、トランシーバーは基となる変調周波数を2倍にすることなく、チャネルごとに100G-PAM4を伝送できます。その結果、各チャネルは生のラインレートが約106.25Gbpsに達し、前方誤り訂正のオーバーヘッドを差し引いた後、100Gのペイロードを伝送できます。
PAM4信号と従来のNRZ信号の主な違い
従来の光ネットワークは、バイナリのオン/オフ状態を用いて単一ビットを伝送するNRZ(Non-Return-to-Zero)変調方式に依存していました。NVIDIA MMA4Z00-NS400はPAM4方式に移行することで、限られた電気的および光学的帯域幅内で高いスループットを実現できますが、アイハイトのマージンが小さくなるため、より高い信号精度が求められます。
以下の比較は、これら2つのシグナリング方式が主要な運用指標においてどのように異なるかを示しています。
| 従来のNRZ信号方式 | PAM4シグナル伝達 | |
| 電圧/光レベル | 2段階(低、高) | 4つのレベル(00、01、10、11) |
| シンボルあたりのビット数 | クロックサイクルごとに1ビットの遷移 | クロック遷移ごとに2ビット |
| 必要な帯域幅 | ビットレートあたりのフル周波数 | 同等のビットレートの半分の周波数 |
| 信号対雑音比(SNR) | 騒音に対する耐性が高い(約9.5dBの優位性) | より狭いアイマージン。DSPクリーンアップが必要 |
| レーンごとの料金 | 通常は25G/50G付近で上限に達する | 100G(シンボルレート53.125 GBd) |
内蔵DSP波形整形およびパルス回復機能
4つの異なる光振幅を1つの光チャネルに圧縮すると、垂直方向のアイパターンが必然的に圧縮され、信号がノイズや減衰の影響を受けやすくなります。NVIDIA MMA4Z00-NS400は、専用のデジタル信号プロセッサ(DSP)を信号経路に直接統合することで、この物理的な制約を克服しています。このチップは、高速プリント回路配線や寄生容量によって生じる歪みを能動的に補正します。
送信経路では、DSPはフィードフォワード等化(FFE)を適用して、VCSELドライバをトリガーする前に歪んだ電気波形を整形します。光パルスが戻ってくると、DSPのクロックおよびデータリカバリ(CDR)回路が劣化パルスをサンプリングし、アナログジッタを除去して、下流のスイッチ処理用に鮮明なデジタルシンボルを再構築します。この継続的な等化により、クラスタトラフィックが多い場合でも、エンドツーエンドのデータ転送が確実に行われます。
↘️ NVIDIA MMA4Z00-NS400 を使用した場合、光は光ファイバーケーブルをどのように伝わりますか?
トランシーバーがクリーンなPAM4光パルスを整形した後、これらの信号は構造的な整合性を失うことなく物理的なケーブルを介して伝送されなければなりません。NVIDIA MMA4Z00-NS400は、高精度なマルチファイバー結合と誘電体波誘導を利用して、高密度に配置されたサーバー列全体に高速光パルスを伝送します。
MPO-12光ファイバーインターフェースを通る光伝送経路
NVIDIA MMA4Z00-NS400の光ポートは、業界標準のMPO-12/APCレセプタクルを備えており、複数のファイバーを正確な位置に固定します。内部ガイドピンにより、外部ファイバーフェルールがモジュールのマイクロレンズアレイに直接接触し、カップリングの傾きを最小限に抑えます。この機械的なインターフェースは、4本の専用送信ファイバーと4本の専用受信ファイバーを同時に配線し、12ファイバーリボンの残りの4つの位置はこの構成では使用されません。
アングルド・フィジカル・コンタクト(APC)研磨は、フェルール表面に8度の傾斜を設けることで反射エネルギーを制御します。迷光は、敏感なVCSEL共振器に跳ね返るのではなく、ファイバーの外側クラッドに無害に偏向されます。この精密な形状により、光反射損失の基準が維持され、反射光子が送信機を不安定化させるのを防ぎます。
マルチモードファイバーコア内部における850nm光波の導波
光コネクタを通過した後、各850nmビームは、低屈折率クラッド層に囲まれた50ミクロンのマルチモードガラスコアに入射します。屈折率境界は、連続的な全反射によって光パルスをコア内部に閉じ込めます。この誘電体境界により、高強度の光がパッチケーブルの物理的な曲面に沿って伝送されることが保証されます。
最新のOM4ケーブルは、中心から外側のクラッドに向かってガラス密度が徐々に低下するグレーデッドインデックス構造を採用しています。より長く外側の経路を伝わる光は、密度の低いガラス中をより高速で通過する一方、中心の直線光線は、密度の高い媒体中をより低速で通過します。このグレーデッドプロファイルにより、異なるモードの到達時間が均一化され、合成光波がタイトで読み取りやすい状態を維持します。
ケーブル長全体にわたる光信号の損失と減衰
NVIDIA MMA4Z00-NS400リンクのガラス経路を光パルスが伝搬するにつれて、その光パワーは距離とともに徐々に減少します。ガラス固有の吸収とレイリー散乱により、光子の一部は熱または散乱光としてコアから放出されます。850nmリンクでは、これらのガラスの不完全性が、850nmにおけるファイバーの最大減衰量3.0dB/km(通常値は約2.5dB/km)に寄与します。
構造化ケーブル配線における物理的なコネクタ接合部およびアダプタごとに、追加の挿入損失が発生します。嵌合したMPO接合部ごとに、通常0.35dB(最大0.75dB)の挿入損失が発生し、フェルール端面の汚れやエアギャップによって損失がさらに大きくなる可能性があります。リンク全体の減衰量がモジュールの校正済みリンクバジェットを超えると、受信側のフォトダイオードはPAM4電圧閾値と背景の熱雑音を区別することが困難になります。
標準OM4マルチモードファイバーの物理的な到達距離制限
標準的な減衰によって光パワーは低下しますが、モード分散が最終的にNVIDIA MMA4Z00-NS400の物理的な距離制限を決定します。異なる光線が50ミクロンのコアを通過する際にわずかに異なる空間モードをとるため、光パルスはファイバーに沿って伝搬するにつれて時間的に広がります。1レーンあたり53.125GBdという極めて高速な変調速度では、この深刻なパルス広がりによって隣接するシンボルが重なり合い、大きなシンボル間干渉(ISI)が発生します。
読みやすいアイパターンを維持するため、トランシーバーはOM4マルチモードファイバー上で最大50mの伝送距離で動作するように正式に規定されています。古いOM3ケーブルにモジュールを敷設すると、モード帯域幅が低いため、動作範囲は約30mに制限されます。これらの物理的な伝送距離の制限を遵守することで、下流の受信機はネットワークのエラー訂正閾値を超えることなく、すべての4レベルPAM4パルスを確実に復元できます。
↘️ NVIDIA MMA4Z00-NS400にとって、熱制御が重要な理由とは?
並列光ファイバーレーンを介して高速PAM4信号を伝送するには、超高密度な物理的フットプリント内で相当な電力が必要となります。NVIDIA MMA4Z00-NS400は、複数のアクティブ半導体を密閉された金属筐体に集積しているため、リンクの安定性を維持するには放熱が不可欠です。
高速光DSPチップからの熱エネルギー出力
NVIDIA MMA4Z00-NS400内部の主要な発熱源は、内蔵のDSPチップです。マルチギガヘルツの周波数で動作し、4つの並列100Gレーンを処理するため、数十億個の微小なシリコントランジスタが複雑なイコライゼーションアルゴリズムを実行するために状態を連続的に切り替えます。この高速なスイッチング動作により、相当量の動的電力損失が発生し、局所的な熱エネルギーがトランシーバー基板に直接放出されます。
DSPはモジュールの消費電力の主要因として広く認識されており、フルロード時で通常7W~8W、最大仕様では8.5Wを消費するため、内部に急激な温度勾配が生じます。熱がこもると内部接合部の温度が上昇し、シリコンの効率が低下し、リーク電流が増加します。DSPパッケージから熱を継続的に除去しないと、すぐに熱スロットリングや信号障害が発生します。
放熱性を考慮したフラットトップOSFPシェル設計
フィン付きトップの光トランシーバーとは異なり、NVIDIA MMA4Z00-NS400は、アダプタやスイッチ環境向けに特別に設計された、滑らかでフラットなトップのOSFPハウジングを備え、シャーシ冷却機能を内蔵しています。NVIDIA ConnectX-7などのネットワークアダプタに挿入すると、フラットな上面がコネクタケージに取り付けられたヒートシンクと直接接触し、熱抵抗の低い経路が形成されて、内部のVCSELアレイとDSPから熱を上方に逃がします。
高速システムファンがホストの冷却フィンに強制的に気流を送り込み、蓄積された熱負荷を排出します。OSFPケージのバネ式クリップは、フラットシェル全体に一定のクランプ圧力を維持し、機械的な振動時でも安定した導電接触を確保します。この協調冷却方式により、高負荷のデータ転送時でも動作ケース温度は標準的な0℃~70℃の範囲内に維持されます。
レーザー性能に対する高温動作リスク
過度の動作熱は、トランシーバー内部の繊細な850nm VCSELアレイに即座に物理的な脅威をもたらします。熱の影響により、物理的な共振器長と半導体材料の屈折率の両方が変化し、共振波長がより長い赤外線帯域へとシフトします。内部温度が臨界閾値に近づくと、光出力は深刻な動作不良に見舞われます。
閾値電流の増加:熱エネルギーが増加すると、レーザー発振を開始させるだけでもより大きな駆動電流が必要となる。
- 傾斜効率の低下:量子効率が悪化し、電流1ミリアンペアあたりに生成される光出力パワーが低下します。
- 相対強度ノイズ(RIN)の上昇:キャリアの振動が増加すると、ランダムな光子変動が増幅され、PAM4アイの開口が劣化します。
- ダイオードの劣化促進:継続的な熱ストレスは結晶欠陥の伝播を加速させ、VCSELの全体的な寿命を大幅に短縮します。
これらの熱によるペナルティが複合的に作用することで、光学的なアイマージンが圧縮され、最終的にPAM4のクリーンな検出が不可能になります。したがって、ケース温度の厳密な境界を維持することが第一の防御策であり、熱マージンが狭い場合は、FECとDSPベースの信号回復が不可欠な第二の防御策となります。
↘️ NVIDIA MMA4Z00-NS400 はどのようにして信号エラーを防ぐのですか?
最適な放熱を実現したとしても、4レベル光パルスは高密度ファイバー伝送においてアナログ歪みやチャネル減衰の影響を受けやすい。NVIDIA MMA4Z00-NS400は、高度なデジタル信号処理とアルゴリズムによるエラー軽減によってこれらの物理的な劣化を抑制し、ビットの完全性を維持する。
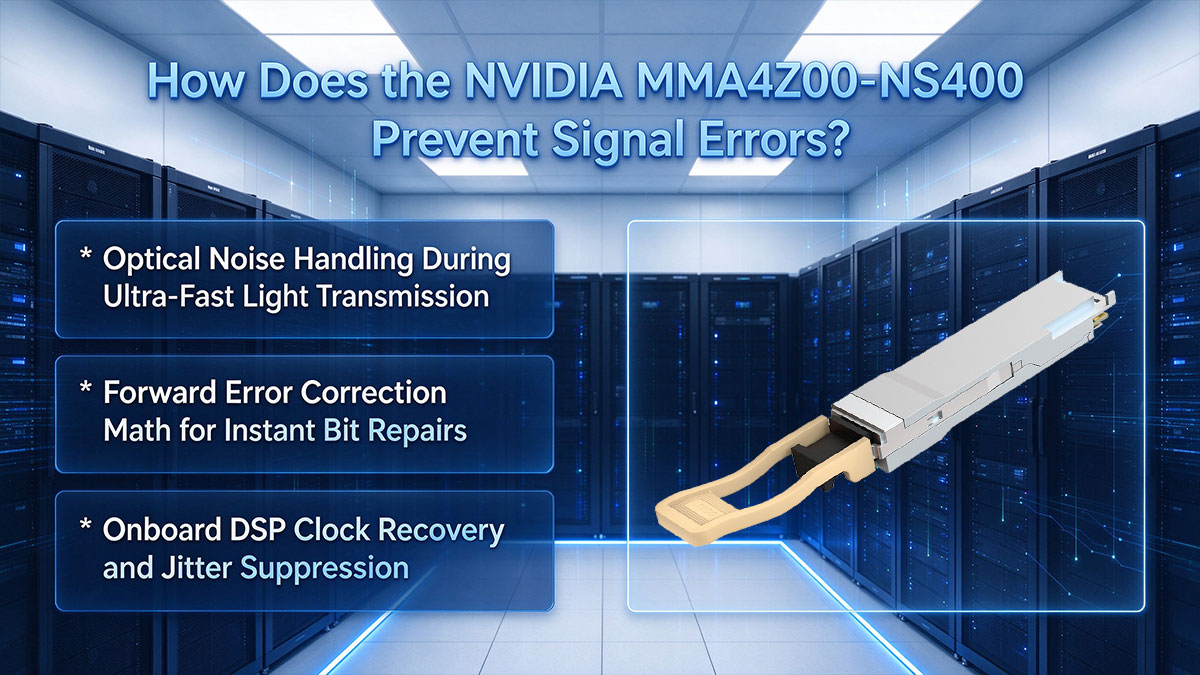
超高速光伝送時の光ノイズ処理
4つの100Gレーンを53.125GBdで動作させると、アイパターンの開口部が大幅に狭くなり、わずかな光子変動や熱雑音によってビット反転が発生する可能性があります。NVIDIA MMA4Z00-NS400は、高感度PIN受信フォトダイオードと低雑音トランスインピーダンスアンプ(TIA)を組み合わせることで、これらのアナログノイズによる影響を最小限に抑えます。
これらのフロントエンド受信コンポーネントは、微弱な光信号を安定した電気電圧に変換すると同時に、背景の熱雑音を積極的に抑制します。モジュールは、意味のあるPAM4振幅遷移を自然発生的な光雑音から分離することで、デジタル処理を開始する前にクリーンな信号マージンを維持します。
ビット修復を瞬時に行うための前方誤り訂正の計算
高速PAM4リンクは、当然ながらFEC前のビット誤り率をベースラインとして動作するため、最新の400Gネットワークは物理層のリード・ソロモン前方誤り訂正(RS(544, 514)、別名KP4 FEC)に依存しています。NVIDIA MMA4Z00-NS400は、この構造化されたパリティデータをすべての光レーンに透過的に伝送し、ホストシステムが劣化シンボルをリアルタイムで再構築できるようにします。
KP4アルゴリズムは、514個のデータシンボルごとに30個のパリティシンボルを追加することで、再送信を発生させることなく、コードワードあたり最大15個のシンボルエラーを数学的に修復します。この誤り訂正層により、本来ノイズの多い物理チャネルが、FEC後の実効ビット誤り率が10⁻¹⁵未満となる、実質的にエラーのないリンクへと変換されます。
オンボードDSPクロックリカバリとジッター抑制
スイッチ配線やマルチモードファイバーを通過する高周波信号は、深刻なタイミングジッターと位相ドリフトの影響を受け、シンボル境界が不明瞭になります。NVIDIA MMA4Z00-NS400に内蔵されたDSPは、統合されたクロックおよびデータリカバリ(CDR)回路を使用して、入力シンボルレートに継続的に同期し、サンプリング位相を再調整します。
同期が完了すると、内部のフィードフォワードイコライザ(FFE)やその他の適応フィルタリング段が、高周波減衰と符号間干渉をデジタル的に補正します。このリアルタイムフィルタリングにより、蓄積されたタイミングジッターが除去され、シャープでタイミングが調整されたデジタル波形がホストシステムに供給されます。
↘️ 同じ光学物理学を適用する: LINK-PP NVIDIA MMA4Z00-NS400に対応するソリューション
信頼性の高い 400G 伝送を実現するには、独自のブランドロックではなく、確立された光物理学、信号規格、および物理的許容範囲に厳密に従う必要があります。これらの同一の物理的ルールに基づいてハードウェアを設計することで、 LINK-PP LO-M85400-SR4Cは、NVIDIA MMA4Z00-NS400と電気的および光学的に整合性の取れた代替製品です。
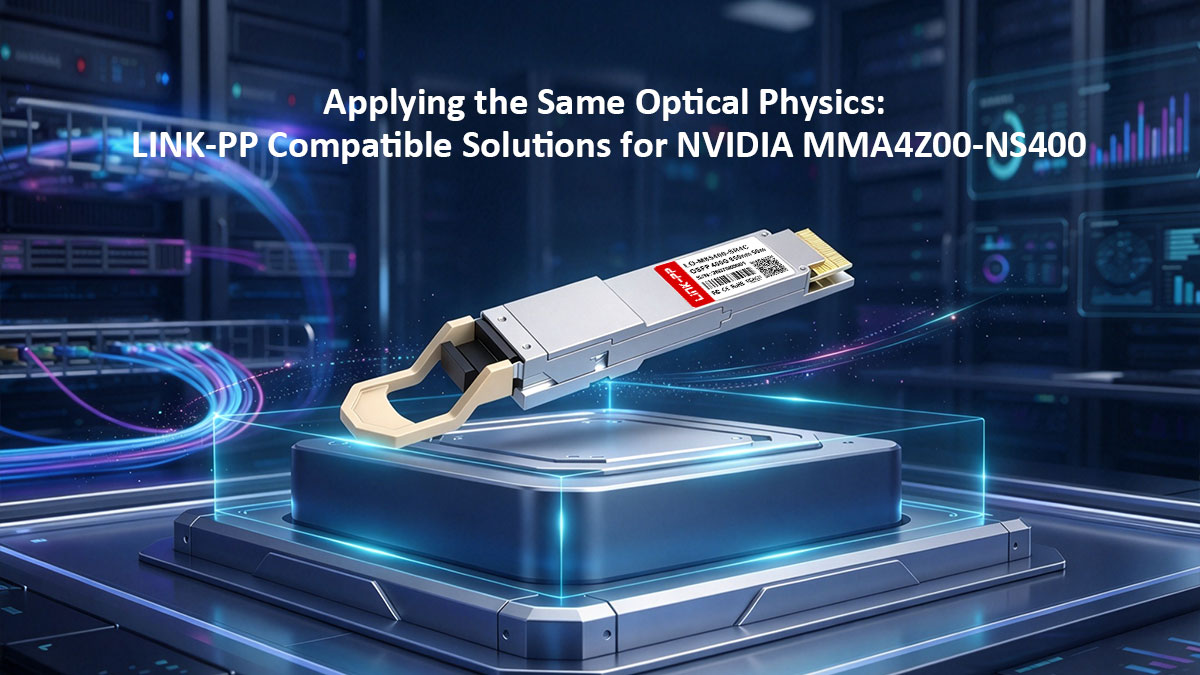
同一の850nm VCSELアレイおよび光出力レベル
その LINK-PP LO-M85400-SR4C 400G OSFP SR4モジュールは、OEMトランシーバーの正確な光入射パラメータを再現するように設計された4チャンネル850nm VCSELアレイを統合しています。各レーザーダイオードは、校正された平均出力と消光比の範囲内で発光し、標準的なマルチモードファイバーへの理想的な光ビーム結合を保証します。
高精度マイクロオプティクスと内部フォトダイオードフィードバックループにより、高負荷時でもレーザーの安定性を維持し、強度ノイズを抑制します。これにより、OM3およびOM4の連続運転において、光送信機がクリーンな検出に必要な正確な光子束を供給することが保証されます。
マッチドPAM4信号変調とDSP処理
高速物理リンクでは、すべてのチャネルで狭いアイ開口部を維持するために、同一の信号整形機能が求められる。 LINK-PP LO-M85400-SR4Cは、1レーンあたり53.125GBdで動作するオンボードデジタル信号プロセッサを使用して、安定した100G-PAM4パルスを生成します。
受信経路では、統合されたクロックおよびデータリカバリとフィードフォワードイコライゼーションにより、高周波ジッタを除去し、チャネル損失を補償します。このアクティブな信号調整により、受信シンボルエラーはKP4 FECの閾値を大きく下回り、ホストシステムとの透過的な互換性が確保されます。
等価熱設計および消費電力プロファイル
持続的な光学性能には、既存のデータセンターの気流とホストの機械的エンベロープに適合する熱挙動が必要です。 LINK-PP LO-M85400-SR4C OSFPモジュールは、精密加工されたフラットトップOSFPハウジングを採用しており、アダプタカードやスイッチシャーシ内のケージマウント型ヒートシンクとシームレスに嵌合します。
内部コンポーネントは、同等の消費電力範囲内で動作するように最適化されています。通常、400Gbpsの連続トラフィック時で7W~8W、最大仕様は8.5Wです。この厳密な熱設計により、局所的なホットスポットの発生を防ぎ、モジュールは標準的な商用動作範囲全体で安定したケース温度を維持できます。
NVIDIA SwitchハードウェアとのEEPROM互換性
ハードウェアレベルの光学的パリティは、物理管理層におけるデジタル認識と組み合わせる必要がある。 LINK-PP LO-M85400-SR4Cは、CMIS規格およびNVIDIAファームウェア検証ルーチンに厳密に準拠するようにフォーマットされた、プログラム済みのEEPROMメモリを搭載しています。
NVIDIA Quantum-2 InfiniBandスイッチまたはConnectX-7ネットワークアダプタに接続すると、ホストは標準のI²Cバスを介してシリアル番号、速度ビットマップ、および診断テレメトリを読み取ります。事前に構成されたEEPROMデータは、標準初期化中にCMISステートマシンシーケンスを満たし、モジュールが手動操作なしでリンク初期化を完了し、400Gポートを起動できるようにします。
↘️ 結論:NVIDIA MMA4Z00-NS400の背後にある物理学をマスターする
最新のAIファブリックにおいて信頼性の高い400G接続を実現するには、レーザー光の生成、パルス化、冷却方法を理解することが不可欠です。NVIDIA MMA4Z00-NS400は、850nm VCSELアレイと100G-PAM4 DSP信号伝送を、堅牢なフラットトップ型熱伝導と組み合わせることで、リンクの安定性を維持し、このバランスを実現しています。
標準的なマルチソースアグリーメント(MSA)とIEEE仕様によって統一された物理的基準が確立されているため、これらの共通規格に基づいて構築された高速トランシーバーは、高密度クラスタ全体で幅広い相互運用性を実現します。大規模なAIファブリックを拡張する際、ネットワークチームは、リンク性能を犠牲にすることなく調達予算と供給の可用性を最適化するために、互換性が検証済みのトランシーバーを求めることがよくあります。
これらの同一の光学、電気、熱パラメータに準拠した信頼性の高い代替品を探しているエンジニアにとって、 LINK-PP LO-M85400-SR4C 400G OSFP SR4光モジュールは、実績のあるドロップイン互換性を提供します。詳細な技術仕様を確認し、ネットワークインフラストラクチャに適合するモジュールを評価するには、次のサイトをご覧ください。 LINK-PP オフィシャルストア.