Live-Chat
Wir sind rund um die Uhr für Sie da.
Schreiben Sie uns jetzt, um schnell eine Antwort zu erhalten.
Alle Kategorien
SFP-Module
Services
Unterstützung
Über uns
Ressourcen
Kümmern Sie sich um Ihr Geschäft mit einer Vielzahl vertrauenswürdiger Zahlungsoptionen.
Verwenden Sie die Bestellnummer oder die Sendungsverfolgungsnummer, um den Versandstatus zu überprüfen.
Erhalten Sie schnell Ihr Angebot und profitieren Sie von einem professionelleren Service.
Helfen Sie dabei, Ihr Budget und Ihre Ausgaben besser zu verwalten.
Kostenlose Probenunterstützung, um Ihre Testergebnisse effizient zu erzielen.
Professionelle Teamunterstützung und Service, um Ihre Probleme rechtzeitig zu lösen.
Fragen Sie uns, was immer Sie interessiert, wir helfen Ihnen rund um die Uhr.
Erhalten Sie schnell Ihr Angebot und bieten Sie einen professionelleren Service.
Lernen Sie uns kennen und erfahren Sie mehr über unsere Mission, unseren Glauben, unseren Service und mehr.
Finden Sie unsere Standorte und vernetzen Sie sich intensiv mit uns.
Qualitätsmanagement, Tests, Kompatibilität und globale Konformität.
Laborrundgang, optischer Prüfstand, Kompatibilitätstool und Testanforderungen.
Erfahren Sie die neuesten Nachrichten und Veranstaltungen in der Umgebung l-p.com
Tiefgehende Einblicke in technische Leitfäden, Industriestandards und SFP-Kompatibilität.
Detaillierte Produkt-Benchmarks und direkte Vergleiche helfen Ihnen bei der Auswahl des richtigen Moduls.
Entdecken Sie praxisnahe Konnektivitätslösungen für Rechenzentren, Unternehmen und Telekommunikationsnetze.
Wichtige Tipps zur Auswahl von Datenraten, Übertragungsdistanzen und Steckertypen.
Neukunde? Konto erstellen


Die rasante Zunahme komplexer KI-Anwendungen führt weltweit zu einem dringenden Bedarf an ultraschneller Netzwerkinfrastruktur. Moderne Rechenzentren benötigen heutzutage extrem hohe Bandbreiten, um Latenzengpässe zu vermeiden und massive, parallele Rechenaufgaben effizient und unterbrechungsfrei zu verarbeiten.
Das Silicon Valley AI Computing Cluster Project begegnet dieser gravierenden Herausforderung und dient als wegweisendes Beispiel für Netzwerkinnovationen der nächsten Generation. Kern dieses Erfolgs ist die nahtlose Implementierung von LINK-PP 100GBASE-SR4 Optischer Transceiver integriert in eine leistungsstarke HPE ProLiant Serverumgebung und gewährleistet so eine beispiellose Stabilität der Datenübertragung.
Dieser Artikel beschreibt die strategische Synergie zwischen diesen Hardwaretechnologien und bietet einen umfassenden Überblick über die betrieblichen Auswirkungen der Lösung. Die folgenden Abschnitte behandeln die folgenden wesentlichen Themen:
Überwindung schwerwiegender Datenübertragungsengpässe in modernen Rechenclustern.
Technische Kernspezifikationen des LINK-PP Optisches Modul 100G.
Erfolgsmetriken für die Implementierung und Verbesserung der Systemzuverlässigkeit.
Durch die Untersuchung dieses bewährten Netzwerkeinsatzes gewinnen IT-Experten wertvolle Erkenntnisse für die Optimierung ihrer eigenen unternehmensweiten IT-Infrastruktur, um zukünftige technologische Fortschritte zu unterstützen.
KI-Computing-Architekturen in führenden Technologiezentren stehen vor enormen Herausforderungen hinsichtlich des Datendurchsatzes. Daher ist der sofortige Übergang zu einer Hochgeschwindigkeitsinfrastruktur mit 100G unerlässlich, um Systemengpässe zu vermeiden. Um den kontinuierlichen Datenfluss zu gewährleisten, der für fortschrittliche Modelle des maschinellen Lernens erforderlich ist, hat sich der Einsatz von leistungsstarker Enterprise-Hardware wie dem HPE ProLiant Server in Kombination mit hochwertigen optischen Transceivern als bewährte Branchenstrategie etabliert. Das Silicon Valley AI Computing Cluster Project veranschaulicht eindrucksvoll, warum die Geschwindigkeiten herkömmlicher Netzwerke den aktuellen Anforderungen nicht mehr genügen und wie die Integration fortschrittlicher Konnektivitätslösungen diese kritischen betrieblichen Hürden überwindet.
Das exponentielle Wachstum des parallelen KI-Trainings und komplexer Algorithmen für maschinelles Lernen erfordert zwingend massive Bandbreitenkapazitäten auf allen Netzwerkebenen. Herkömmliche Netzwerkstandards sind nicht mehr in der Lage, die Echtzeit- und Hochleistungsverarbeitungsanforderungen moderner KI-Rechenzentren zu erfüllen.
Um diesen grundlegenden Wandel vollständig zu verstehen, ist es wichtig, die betrieblichen Einschränkungen älterer Netzwerkkonfigurationen zu identifizieren:
Bei 10G- oder 40G-Verbindungen kommt es häufig zu starken Datenüberlastungen während Spitzenzeiten im Bereich des maschinellen Lernens.
Veraltete Netzwerkinfrastrukturen führen zu inakzeptablen Latenzzeiten, was die Effizienz paralleler Rechenprozesse stark beeinträchtigt.
Langsamere Verbindungen bieten nicht die unmittelbare Skalierbarkeit, die für schnell wachsende Unternehmensdatencluster erforderlich ist.
Durch die Überwindung dieser traditionellen Beschränkungen können Rechenzentrumsbetreiber einen kontinuierlichen, schnellen Datenfluss gewährleisten. Der Übergang zu einem dedizierten 100G-Backbone ist keine optionale Erweiterung mehr, sondern eine zwingende Voraussetzung, um mit dem rasanten Tempo der Entwicklung künstlicher Intelligenz Schritt halten zu können.
Der HPE ProLiant Server spielt eine zentrale Rolle bei der Ausführung komplexer Rechenaufgaben und bietet die robuste Rechenleistung und Hardwarezuverlässigkeit, die Premium-Rechenzentren benötigen. Um das enorme Rechenpotenzial dieses Servers voll auszuschöpfen, muss die zugrundeliegende Netzwerkinfrastruktur jedoch perfekt auf seine anspruchsvolle Hardwarearchitektur abgestimmt sein, ohne die Signalqualität zu beeinträchtigen.
Im Rahmen des Silicon Valley AI Computing Cluster Projekts stellten Netzwerktechniker fest, dass der Einsatz eines hochkompatiblen 100G-Glasfaser-Transceivers für eine optimale Systemleistung unerlässlich ist. Der HPE ProLiant Server benötigt vollständig nahtlose Kommunikationskanäle innerhalb seines Ökosystems, um Terabytes an KI-Trainingsdaten effizient zu verarbeiten und zu verteilen.
Die Implementierung des passenden optischen Hochgeschwindigkeitsmoduls gewährleistet eine ausgewogene technologische Synergie innerhalb der Serverracks. Diese präzise Abstimmung von Spitzenrechenleistung und verlustfreier Netzwerkanbindung garantiert, dass die Unternehmensserver mit maximaler Verarbeitungskapazität arbeiten können – völlig frei von Drosselung durch das physische Netzwerk.
Das LINK-PP Der optische Transceiver LQ-M85100-SR4C bildet die entscheidende Hardwaregrundlage für echte 100G-Konnektivität in anspruchsvollen KI-Infrastrukturen. Durch die Kombination fortschrittlicher optischer Technologie mit robuster Anpassungsfähigkeit an verschiedene Umgebungen erfüllt dieses Modul optimal die strengen Datenübertragungsanforderungen des Silicon Valley AI Computing Cluster Projects. Seine präzise Konstruktion gewährleistet maximalen Durchsatz auf Unternehmensservern ohne Kompromisse bei Energieeffizienz oder Systemstabilität.
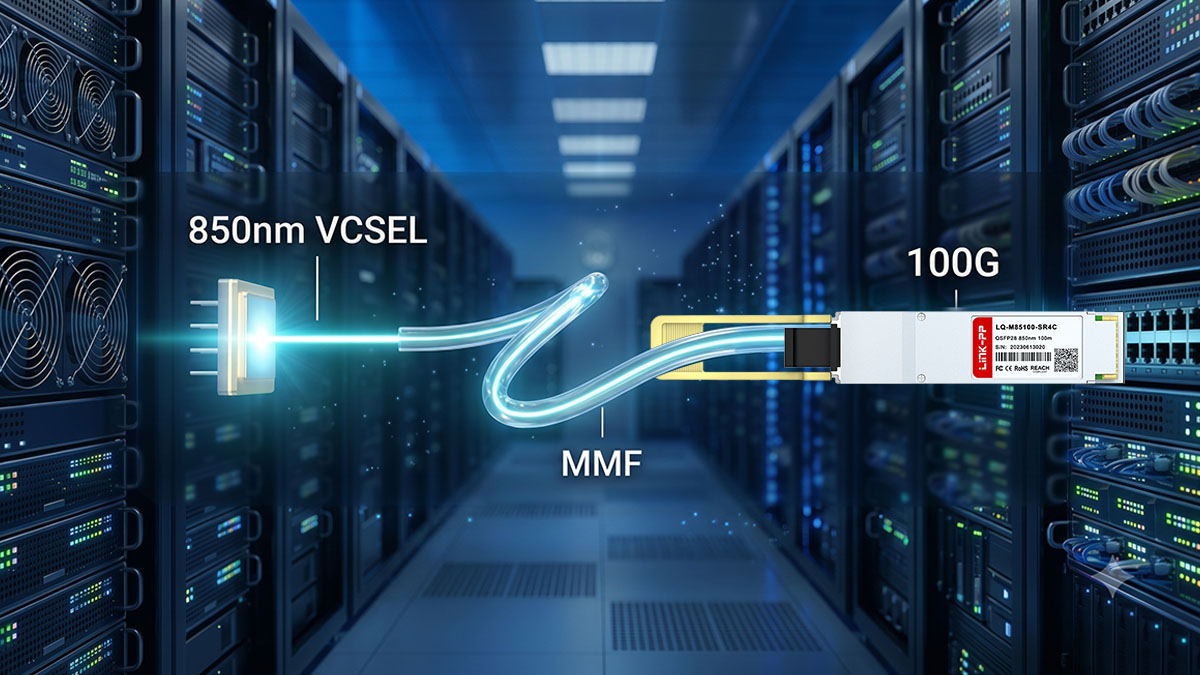
Um eine außergewöhnliche Netzwerkleistung zu erzielen, LINK-PP Das LQ-M85100-SR4C nutzt eine fortschrittliche Mehrspurarchitektur für unterbrechungsfreie Datenübertragung mit hoher Kapazität. Dieses Modul garantiert echten 100G-Standard und ist damit die optimale Wahl für die anspruchsvollen Anforderungen moderner KI-Zentren hinsichtlich der Konnektivität innerhalb und zwischen Racks.
Die folgenden technischen Parameter heben die Kernspezifikationen hervor, die es diesem Transceiver ermöglichen, eine einwandfreie Signalintegrität über verschiedene Glasfaserkonfigurationen hinweg aufrechtzuerhalten:
| Technische Parameter | Spezifikationswert | Betriebsvorteil |
| Übertragungsdatenrate | 4 × 25.78125 Gbit/s pro Kanal | Bietet echte 100G Bandbreite für parallele KI-Workloads. |
| Optische Technologie | 850 nm VCSEL | Gewährleistet hohe Zuverlässigkeit und starke Signalabgabe. |
| Faserkompatibilität (OM3) | Bis zu 70 Meter | Deckt perfekt Standard-Serververbindungen innerhalb eines Racks ab. |
| Faserkompatibilität (OM4) | Bis zu 100 Meter (mit FEC) | Gewährleistet stabile Verbindungen zwischen den Racks auf der gesamten Hallenfläche. |
Durch die Nutzung dieser präzisen Spezifikationen eliminiert der Transceiver effektiv das Risiko von Datenverlusten über wesentliche physikalische Distanzen. Dieses robuste optische System gewährleistet einen kontinuierlichen und schnellen Informationsfluss zwischen den einzelnen Serverknoten des KI-Rechenclusters.
Neben der reinen Verarbeitungsgeschwindigkeit ist die Aufrechterhaltung eines optimalen Stromverbrauchs und einer stabilen Wärmeentwicklung für dicht gepackte Hardware-Layouts, wie sie beispielsweise in HPE ProLiant Server-Ökosystemen zu finden sind, absolut entscheidend. LINK-PP Der LQ-M85100-SR4C wurde speziell entwickelt, um den Energieaufwand zu minimieren und gleichzeitig in hochkonzentrierten Hochleistungsrechner-Racks einwandfrei zu funktionieren.
Das optische Modul verfügt über wichtige elektrische und thermische Eigenschaften, die die umliegende Infrastruktur vor kostspieligen Überhitzungsproblemen schützen sollen:
Maximaler Stromverbrauch: Begrenzt auf extrem niedrige 2.5 W, wodurch der Gesamtenergieverbrauch der Anlage deutlich reduziert wird.
Elektrische Versorgung: Betrieb mit einer einzigen +3.3V-Stromversorgung, was eine unkomplizierte elektrische Integration gewährleistet.
Gehäusetemperaturbereich: Gewährleistet einen sicheren, kontinuierlichen Betrieb innerhalb eines Temperaturfensters von 0℃ bis +70℃.
Diese optimierten Umgebungsparameter verhindern direkt eine thermische Drosselung während Spitzenlastzyklen. Daher können Rechenzentrumsbetreiber diese Hochgeschwindigkeitsmodule bedenkenlos dicht im Netzwerk einsetzen, ohne dass umfangreiche und kostspielige Aufrüstungen der bestehenden Kühlsysteme erforderlich sind.
Die praktische Umsetzung des Silicon Valley AI Computing Cluster Projekts demonstrierte den immensen Nutzen standardisierter, hochkompatibler optischer Hardware. Durch die Integration der LINK-PP Durch die nahtlose Integration des LQ-M85100-SR4C in die HPE ProLiant Serverarchitektur konnten Netzwerktechniker eine schnelle Bereitstellung und sofortige Systemstabilität erreichen. Diese Praxisanwendung beweist, dass die Kombination von erstklassigen Serverkonfigurationen mit hochwertigen optischen Transceivern direkt zu messbarem Betriebserfolg und langfristiger Netzwerkstabilität führt.
Die Realisierung einer unterbrechungsfreien Installation und einer mühelosen Langzeitwartung hängt vollständig von der physischen Konstruktion und der Hardwarekompatibilität der ausgewählten Netzwerkkomponenten ab. Während des Projekts wurde die intuitive Struktur des LINK-PP Der Transceiver ermöglichte es den IT-Teams, komplexe, manuelle Konfigurationsprozesse zu umgehen, was zu einer außergewöhnlich effizienten Integrationsphase führte.
Die erfolgreiche und schnelle physische Installation dieses Moduls in die dichte Serverinfrastruktur wurde durch mehrere entscheidende Konstruktionsmerkmale ermöglicht:
Einzelner MPO12-Anschluss: Diese standardisierte optische Schnittstelle vereinfachte die Glasfaserverkabelung erheblich, reduzierte das physische Durcheinander und minimierte potenzielle Verbindungsfehler innerhalb der Serverschränke.
Elektrisch Hot-Plug-fähig: Diese Architektur ermöglichte das schnelle Einfügen und Austauschen von Komponenten im laufenden Betrieb, ohne dass ein stark störender Systemneustart oder eine Abschaltung des Netzwerks erforderlich war.
Standard 38-Pin Edge QSFP28-Schnittstelle: Diese weit verbreitete Verbindung gewährleistete sofortige Hardware-Erkennung, Stromversorgung und stabile I2C-Kommunikation innerhalb des Server-Ökosystems.
Durch die Nutzung dieser benutzerfreundlichen physischen Schnittstellen konnte das Entwicklungsteam die Installationszeit für das gesamte Rechenzentrum drastisch reduzieren. Dieses unkomplizierte Wartungsprofil gewährleistet, dass zukünftige Netzwerkerweiterungen oder die routinemäßige Komponentenverwaltung mit minimalen Beeinträchtigungen der laufenden KI-Verarbeitung durchgeführt werden können.
Der entscheidende Faktor für den Erfolg jeder Modernisierung eines Unternehmensrechenzentrums ist seine Fähigkeit, unter kontinuierlicher, extremer Betriebsbelastung fehlerfreie Datenausgabe zu gewährleisten. Die Implementierung im Silicon Valley bestätigte, dass die strikte Einhaltung verifizierter Branchenstandards für Netzwerke direkt mit einer verbesserten Clusterzuverlässigkeit und maximaler Rechenproduktivität einhergeht.
Um eine perfekte plattformübergreifende Kompatibilität zu gewährleisten und eine optimale Netzwerkleistung aufrechtzuerhalten, LINK-PP Der LQ-M85100-SR4C arbeitet strikt innerhalb global anerkannter optischer Netzwerkprotokolle:
IEEE Std 802.3bm-Konformität: Gewährleistet, dass das optische Modul die strengen Spezifikationen der physikalischen Schicht und die Leistungsstandards der Ethernet-Verbindung für 100GBASE-SR4-Anwendungen erfüllt.
SFF-8665-Konformität: Gewährleistet eine präzise strukturelle, thermische und elektrische Ausrichtung mit Standard-QSFP28-Ports, die in fortschrittlicher Hardware wie dem HPE ProLiant Server verwendet werden.
Dieses kompromisslose Bekenntnis zu standardisierter Fertigung führte zu einem herausragenden Betriebsergebnis für das Rechenprojekt. Die Implementierung schloss mit einer beeindruckenden Erfolgsbilanz ohne Ausfälle der optischen Verbindung und perfekt optimierter Netzwerklatenz ab und festigte damit die Fähigkeit des Clusters zur kontinuierlichen, rund um die Uhr verfügbaren Generierung von KI-Modellen.
Elite-Rechenzentren benötigen Netzwerkkomponenten, die höchste Zuverlässigkeit und die strikte Einhaltung globaler Netzwerkstandards gewährleisten. Die erfolgreiche Integration in das Silicon Valley AI Computing Cluster Project zeigt, warum Branchenführer diese Komponenten immer wieder wählen. LINK-PP Hardware für ihre wichtigsten Infrastruktur-Upgrades. Durch die direkte Beschaffung authentischer Netzwerkkomponenten über den LINK-PP Offizieller ShopAnlagenbetreiber sichern sich eine garantierte Hardwarequalität, die perfekt mit High-End-Computergeräten wie dem HPE ProLiant Server harmoniert und so eine solide Grundlage schafft. LINK-PP als zuverlässiger Partner für den Aufbau robuster, hochperformanter Unternehmensarchitekturen.
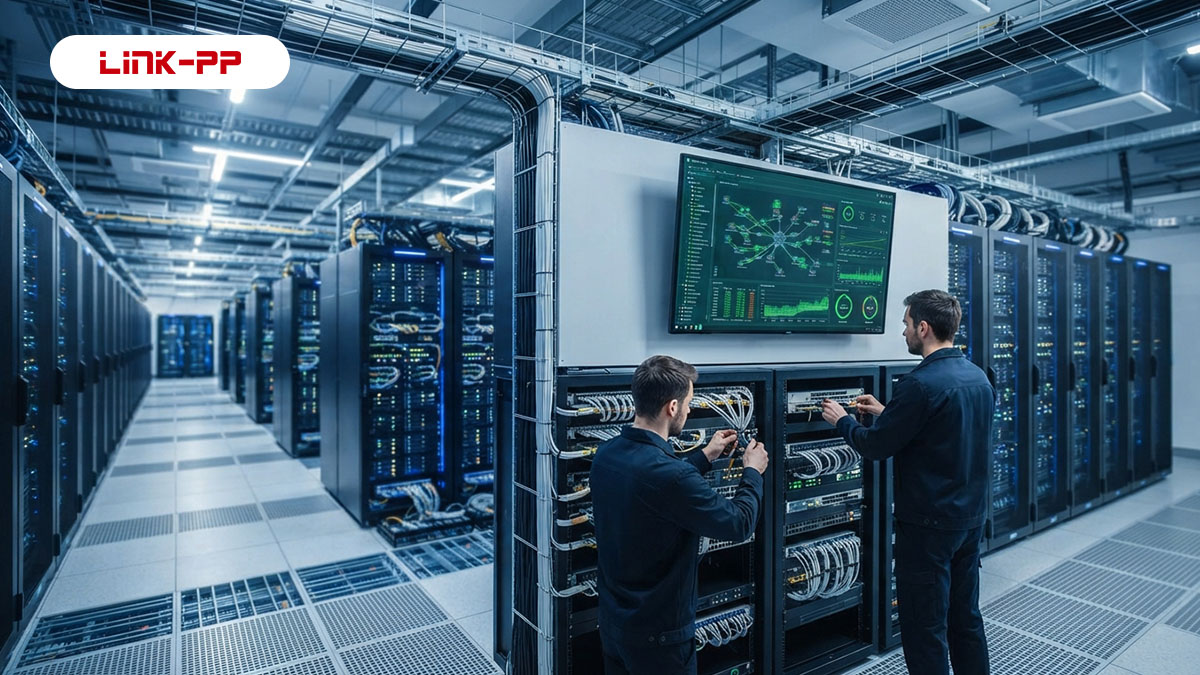
Die Sicherung langfristiger Unternehmensinvestitionen erfordert den Einsatz von Netzwerk-Hardware, die einer strengen Qualitätskontrolle und einer strikten Kompatibilitätsprüfung unterzogen wurde. LINK-PP stellt sicher, dass jeder optische Transceiver die exakten physikalischen und digitalen Spezifikationen erfüllt, die für einen reibungslosen Betrieb in komplexen Serverumgebungen mit mehreren Herstellern erforderlich sind.
Um dieses außergewöhnliche Maß an Betriebssicherheit zu gewährleisten, gelten für die Herstellung und Prüfung folgende Protokolle: LINK-PP Die Optik konzentriert sich auf mehrere wichtige Säulen der Qualitätssicherung:
Strikte RoHS-Konformität: Gewährleistet, dass alle Transceiver-Komponenten umweltverträglich sind, indem gefährliche Stoffe eingeschränkt und ein nachhaltiger Anlagenbetrieb unterstützt werden.
Umfassende IEEE-Verifizierung: Gewährleistet einwandfreie Interoperabilität und konsistente Datenübertragung über Premium-Netzwerk-Switches und Enterprise-Server-Ports hinweg.
Intensive plattformübergreifende Tests: Minimiert das Risiko von Hardware-Ausfällen oder Firmware-Konflikten bei der Integration in anspruchsvolle Rechnerarchitekturen.
Durch die Einhaltung dieser strengen Qualitätsstandards, LINK-PP Bietet Anlagenbetreibern die absolute Gewissheit, dass ihre Netzwerk-Upgrades auch unter Dauerbelastung zuverlässig funktionieren. Diese bewährte Synergie mit erstklassiger Hardware untermauert letztendlich den Erfolg. LINK-PP als vertrauenswürdiger Anbieter für die Durchführung hochkomplexer Rechenzentrumsmodernisierungen.
Da sich Modelle der künstlichen Intelligenz hinsichtlich Umfang und Komplexität ständig weiterentwickeln, muss die grundlegende Netzwerkinfrastruktur in der Lage sein, sich mühelos an zukünftige Rechenanforderungen anzupassen. LINK-PP setzt sich weiterhin mit Nachdruck für die Weiterentwicklung von Hochgeschwindigkeits-Verbindungstechnologien ein und stellt sicher, dass moderne Rechencluster bestens für die nächste Generation datenintensiver Anwendungen gerüstet sind.
Bereitstellen LINK-PP Die Optik innerhalb von Premium-Server-Ökosystemen bietet zukunftsorientierten Unternehmenseinrichtungen mehrere klare strategische Vorteile:
Sofortige Skalierbarkeit der Arbeitslast: Die robuste optische Architektur unterstützt schnell wachsende Machine-Learning-Operationen, ohne dass grundlegende physische Netzwerkumgestaltungen erforderlich sind.
Zukunftssichere Grundlage: Ein hochstabiles 100G-Backbone ermöglicht die reibungslose Integration noch höherer Bandbreitenstandards im Zuge des technologischen Fortschritts.
Optimierter operativer Fokus: Dank zuverlässiger Konnektivität können sich IT-Ingenieure voll und ganz auf die Maximierung der KI-Leistung konzentrieren, anstatt ständig Probleme mit der physischen Verbindung zu beheben.
Dank dieser strategischen Vorteile können fortschrittliche Computerumgebungen ihre operativen Fähigkeiten sicher erweitern. Letztendlich unterstreicht die erfolgreiche Implementierung im Silicon-Valley-Projekt, wie die Integration LINK-PP Hardware ebnet den Weg für eine sichere, effiziente und hochgradig skalierbare Weiterentwicklung globaler Rechenzentren.
Melden Sie sich an oder erstellen Sie ein Konto, um Ihre Anfrage online zu verfolgen.