



По мере масштабирования моделей ИИ сетевые возможности стали столь же важны, как и производительность графических процессоров . Современные рабочие нагрузки ИИ полагаются на распределенные кластеры графических процессоров, которые генерируют огромный трафик между серверами во время обучения и вывода результатов, что делает низколатентные сети с высокой пропускной способностью необходимыми для общей эффективности системы.
Именно здесь кластерные сети искусственного интеллекта играют решающую роль.
Кластерная сеть для ИИ — это высокопроизводительная сетевая инфраструктура, соединяющая серверы с графическими процессорами, системы хранения данных и ускорители ИИ внутри центров обработки данных для ИИ и высокопроизводительных вычислительных сред. В отличие от традиционных корпоративных сетей, кластеры ИИ требуют сверхбыстрой связи между узлами для поддержки распределенных вычислительных платформ, таких как NCCL и связь между графическими процессорами на основе RDMA .
Для уменьшения узких мест и максимального использования графических процессоров в современных архитектурах искусственного интеллекта обычно применяются такие технологии, как:
-
InfiniBand
-
RoCEv2 и RDMA
-
Сети Ethernet без потерь
-
Архитектуры сетей типа «магистраль-лист»
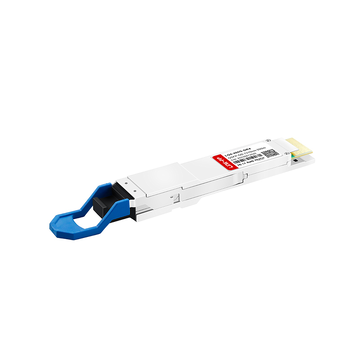
На физическом уровне оптические модули стали ключевым элементом проектирования инфраструктуры искусственного интеллекта. Высокоскоростные оптические трансиверы , такие как модули QSFP-DD и OSFP, обеспечивают масштабируемое соединение 400G и 800G между коммутаторами и серверами с графическими процессорами, сохраняя при этом низкую задержку и высокую плотность портов.
В этом руководстве мы объясним, как работает сетевое взаимодействие в кластерах ИИ, сравним архитектуры InfiniBand и RoCEv2, рассмотрим технологии RDMA и управления перегрузкой, а также изучим, как оптические приемопередающие модули поддерживают масштабируемость современных кластеров ИИ в 2025 году и в последующие годы.
⭐ Что такое кластерная сеть ИИ?
Кластерная сеть для ИИ — это высокопроизводительная сетевая инфраструктура, используемая для соединения серверов с графическими процессорами, ускорителей ИИ, систем хранения данных и коммутаторов внутри центров обработки данных ИИ и высокопроизводительных вычислительных сред (HPC). Ее основная цель — обеспечить чрезвычайно быстрый обмен данными между вычислительными узлами во время распределенных рабочих нагрузок ИИ.
С практической точки зрения, сетевое взаимодействие кластеров ИИ предназначено для решения одной критически важной проблемы: обеспечения полной загрузки графических процессоров во время крупномасштабных задач обучения и вывода результатов. Поскольку современные модели ИИ слишком велики, чтобы эффективно работать на одном графическом процессоре или даже на одном сервере, рабочие нагрузки распределяются по нескольким узлам, которые должны постоянно синхронизировать данные друг с другом. Таким образом, сеть становится частью самой вычислительной системы, а не просто транспортным уровнем.
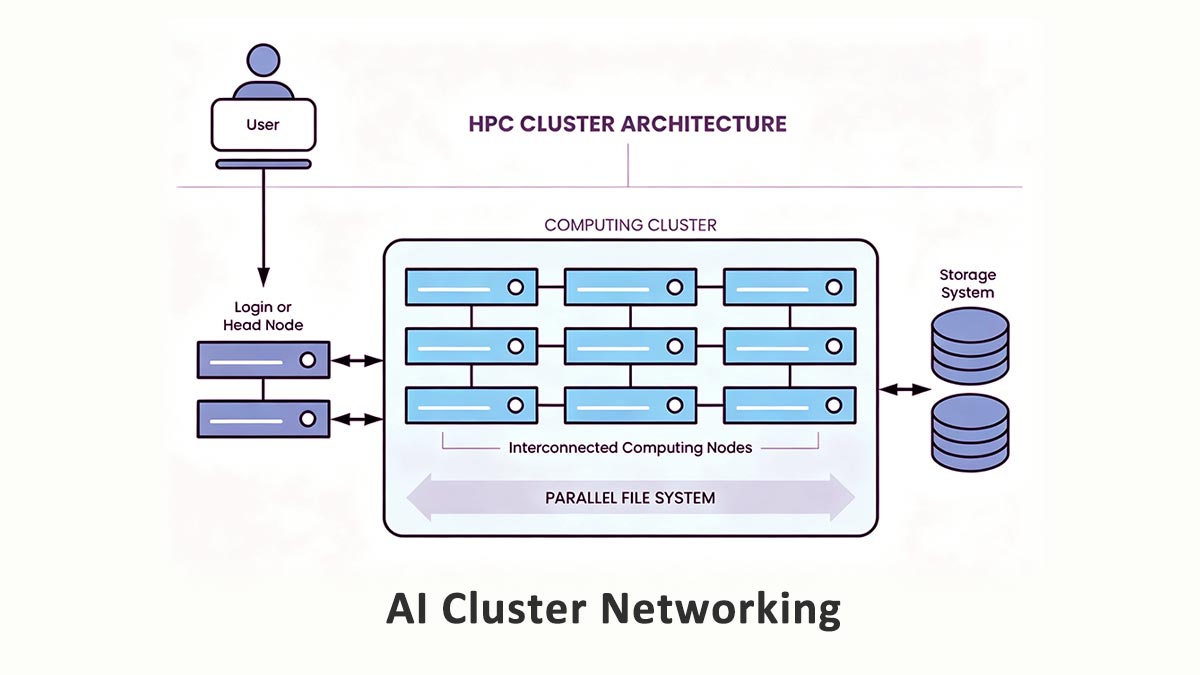
В отличие от традиционных корпоративных сетей, которые в основном обрабатывают обмен данными между пользователями и серверами, кластеры ИИ генерируют огромные объемы трафика «восток-запад» — данных, перемещающихся между графическими процессорами, серверами и системами хранения данных внутри центра обработки данных.
Почему трафик с востока на запад доминирует в обучении ИИ?
Для распределенного обучения ИИ требуется, чтобы графические процессоры непрерывно обменивались градиентами, тензорами, параметрами модели и данными синхронизации. Во время таких операций, как параллельная обработка данных, параллельная обработка тензоров и конвейерная параллельная обработка, каждый графический процессор может одновременно взаимодействовать со многими другими графическими процессорами.
Это приводит к чрезвычайно ресурсоемким маршрутам трафика между востоком и западом.
Например, во время обучения больших языковых моделей (LLM) графические процессоры часто выполняют операции коллективной коммуникации, такие как:
-
All-Reduce
-
Всеобщее собрание
-
Трансляции
-
Уменьшение рассеяния
Эти операции генерируют интенсивный межсетевой трафик, который крайне чувствителен к следующим факторам:
-
Задержка
-
Перегруженность
-
Дрожание
-
переподписка сети
Даже небольшие задержки синхронизации могут привести к тому, что дорогостоящие графические процессоры будут простаивать, что значительно снизит эффективность кластера и увеличит время обучения.
Поэтому в сетевых средах искусственного интеллекта обычно используются следующие технологии:
-
Неблокирующие топологии шиповидных листьев
-
Ткани с поддержкой RDMA
-
Ethernet без потерь или InfiniBand
-
Оптические межсоединения 400G и 800G
-
Интеллектуальные механизмы управления перегрузками
Цель состоит в минимизации накладных расходов на обмен данными и поддержании предсказуемо низкой задержки в кластере.
Требования к сети для обучения и вывода результатов
Хотя и обучение, и вывод результатов работы ИИ основаны на высокоскоростных сетях, их схемы трафика и требования к инфраструктуре существенно различаются.
1. Сети для обучения ИИ
В средах обучения ИИ приоритет отдается следующим аспектам:
-
Сверхнизкая задержка
-
Высокая пропускная способность
-
эффективность синхронизации графического процессора
-
Большая пропускная способность в восточно-западном направлении.
-
RDMA и оптимизация коллективной связи
В обучающих кластерах часто используются сети InfiniBand или RoCEv2 с оптическими модулями 400G/800G для обеспечения непрерывной связи между графическими процессорами в масштабе предприятия.
2. Сети вывода ИИ
В задачах вывода информации обычно больше внимания уделяется следующим аспектам:
-
Быстрое время отклика
-
Масштабируемость для обработки запросов пользователей
-
организация движения с севера на юг
-
Эффективность затрат
-
Балансировка нагрузки
Для кластеров, используемых для вывода результатов, может не потребоваться такой же уровень синхронизации со сверхнизкой задержкой, как для обучающих сред, особенно для одноузловых или слабо распределенных рабочих нагрузок вывода. Во многих случаях достаточно высокоскоростных Ethernet-сетей.
Однако по мере роста масштабных распределенных вычислений и приложений генеративного ИИ в реальном времени требования к сетевым ресурсам для выполнения вычислений также становятся все более высокими, особенно для многоузловых архитектур, обслуживающих ИИ.
⭐ Архитектуры кластерных сетей для ИИ: InfiniBand, RoCEv2 и Ethernet
Выбор правильной сетевой архитектуры для кластера ИИ напрямую влияет на использование графических процессоров, задержку, масштабируемость и стоимость развертывания. Сегодня большинство инфраструктур ИИ строятся на основе трех основных подходов: InfiniBand, RoCEv2 и стандартный Ethernet.
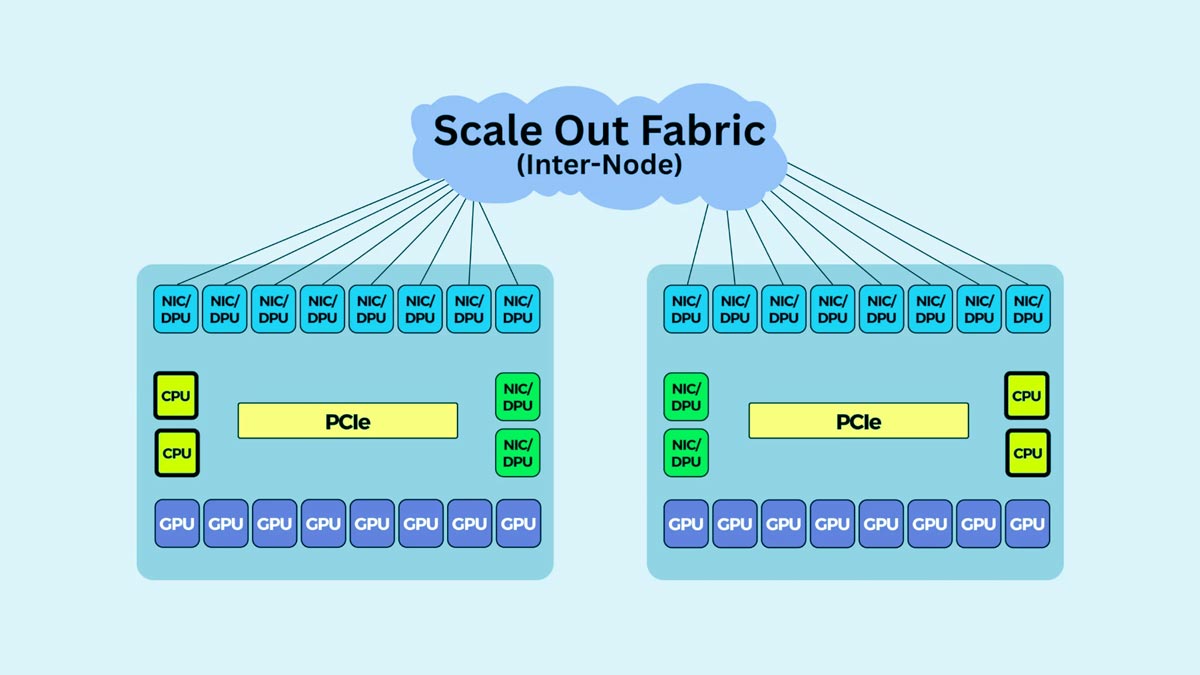
InfiniBand
InfiniBand широко используется в средах высокопроизводительных вычислений и обучения ИИ в гипермасштабных системах, поскольку обеспечивает сверхнизкую задержку, высокую пропускную способность и улучшенное управление перегрузкой. Он оптимизирован для RDMA и крупномасштабной связи с графическими процессорами, что делает его идеальным для распределенных рабочих нагрузок обучения ИИ.
Ключевые преимущества включают в себя:
-
Чрезвычайно низкая задержка
-
Высокая эффективность обмена данными между графическими процессорами.
-
Высокая производительность RDMA
-
Отличная масштабируемость для больших кластеров.
Однако InfiniBand также имеет более высокую стоимость и большую сложность развертывания, что делает его наиболее подходящим для:
-
Крупные кластеры для обучения ИИ
-
Среды высокопроизводительных вычислений
-
Развертывание графических процессоров в нескольких стойках
RoCEv2
RoCEv2 (RDMA поверх конвергентного Ethernet) расширяет возможности RDMA для сетей Ethernet. Он обеспечивает оптимальный баланс между производительностью, масштабируемостью и стоимостью, а также упрощает интеграцию с корпоративной инфраструктурой.
К преимуществам RoCEv2 относятся:
-
Более низкая стоимость, чем у InfiniBand.
-
Совместимость с высокоскоростным Ethernet
-
Хорошая масштабируемость для рабочих нагрузок ИИ.
-
Упрощенная интеграция с корпоративными системами
Для обеспечения стабильной работы RoCEv2 требуется правильная настройка технологий Ethernet без потерь, таких как PFC и ECN.
RoCEv2 обычно используется в:
-
Кластеры корпоративного ИИ
-
Облачная инфраструктура искусственного интеллекта
-
Среды с большим и средним количеством графических процессоров
Стандартный Ethernet
Стандартный Ethernet остается практичным вариантом для небольших развертываний ИИ и кластеров для выполнения инференции, где сверхнизкая задержка синхронизации графических процессоров менее критична.
Преимущества включают в себя:
-
Более низкая стоимость развертывания
-
Упрощенное управление
-
Широкая совместимость
-
Гибкое масштабирование
Современные сети Ethernet 100G и 400G могут эффективно поддерживать множество задач вывода данных в рамках искусственного интеллекта, хотя они могут не соответствовать сетям на основе RDMA для крупномасштабного распределенного обучения.
InfiniBand против RoCEv2 против Ethernet
|
Характеристика |
InfiniBand |
RoCEv2 |
Ethernet |
|---|---|---|---|
|
Задержка |
Самая низкая |
Очень низкий |
Средняя |
|
Поддержка RDMA |
Родной |
Поддержанный |
Ограниченный |
|
Стоимость |
Наивысший |
Средний |
Самая низкая |
|
Многогранность |
Высокий |
Средний |
Низкий |
|
Лучший вариант использования |
Обучение крупномасштабного ИИ |
Кластеры корпоративного ИИ |
Вывод результатов и развертывание на небольших масштабах |
В целом, InfiniBand остается лучшим выбором для достижения максимальной производительности обучения ИИ, RoCEv2 обеспечивает оптимальный баланс стоимости и масштабируемости, а стандартного Ethernet часто достаточно для сред ИИ, ориентированных на вывод результатов.
⭐ Как разработать архитектуру для искусственного интеллекта с низкой задержкой
Разработка архитектуры искусственного интеллекта с низкой задержкой имеет решающее значение для поддержания высокой загрузки графических процессоров и эффективного распределенного обучения. В современных кластерах ИИ сеть должна поддерживать массированный трафик между узлами сети с минимальной перегрузкой, потерей пакетов и задержкой синхронизации.
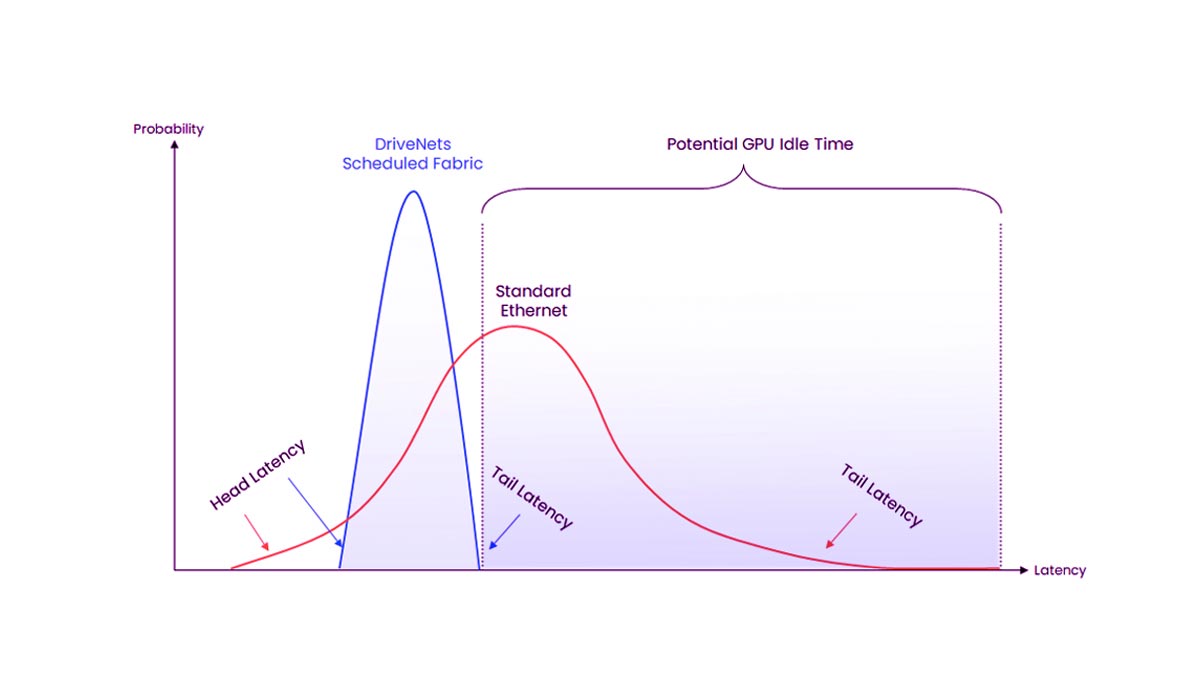
Архитектура с несущими несущими конструкциями и неблокирующими элементами
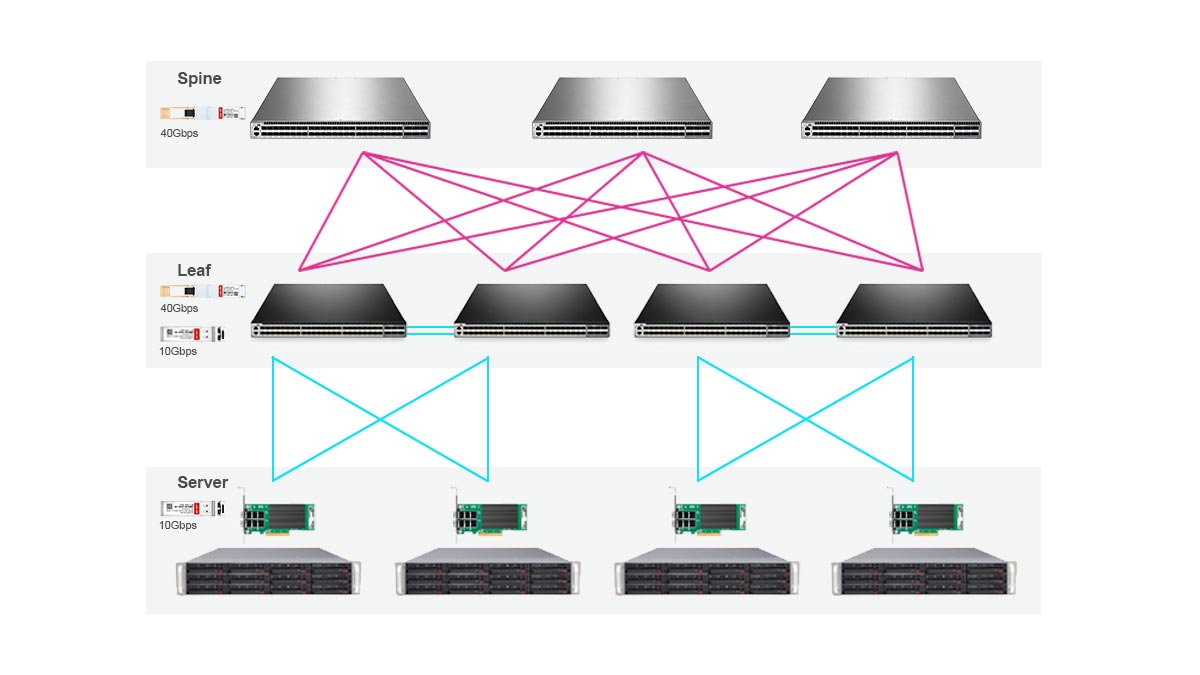
Большинство кластеров ИИ используют топологию spine-leaf, поскольку она обеспечивает предсказуемую связь с низкой задержкой и масштабируемую пропускную способность между узлами с графическими процессорами.
В этой архитектуре:
-
Коммутаторы Leaf подключаются напрямую к серверам с графическими процессорами.
-
Коммутаторы магистральной сети соединяют все коммутаторы конечной сети.
-
Каждый коммутатор-лист имеет пути равной стоимости к другим листам.
Такая конструкция сводит к минимуму узкие места и поддерживает высокоскоростные схемы передачи данных между устройствами искусственного интеллекта, характерные для обучения ИИ.
В крупных проектах по внедрению ИИ часто стремятся к созданию неблокирующей сети , которая обеспечивает достаточную пропускную способность, чтобы избежать конкуренции между узлами во время операций обмена данными между графическими процессорами, таких как All-Reduce и All-Gather.
Стратегия переподписки
Переподписка возникает, когда доступная пропускная способность восходящего канала ниже общей пропускной способности, обращенной к серверу.
Для кластеров, используемых для обучения ИИ, важна низкая степень перегрузки, поскольку распределенные рабочие нагрузки на графических процессорах генерируют непрерывный межсетевой трафик. Высокая степень перегрузки может увеличить задержку и снизить эффективность обучения.
Распространенные подходы включают в себя:
-
Неблокирующие схемы 1:1 для больших кластеров обучения ИИ
-
Низкий коэффициент переподписки для развертываний средних по размеру графических процессоров.
-
Более высокий уровень переподписки в средах, ориентированных на вывод результатов.
Оптимальное соотношение зависит от типа рабочей нагрузки, количества графических процессоров и бюджетных ограничений.
Управление перегрузками и сеть без потерь
Рабочие нагрузки в области искусственного интеллекта крайне чувствительны к потере пакетов и перегрузке сети. Даже небольшие сбои в сети могут замедлить распределенное обучение и привести к простою графических процессоров.
Для повышения стабильности в тканях с искусственным интеллектом обычно используются:
-
Транспорт с поддержкой RDMA
-
Приоритетное управление потоком (PFC)
-
Явное уведомление о перегрузке (ECN)
Эти технологии помогают создать более предсказуемую среду с низкой задержкой для обмена данными между графическими процессорами.
InfiniBand обеспечивает встроенное управление перегрузкой, в то время как развертывание RoCEv2 на основе Ethernet требует тщательной настройки для поддержания работы без потерь.
NCCL, RDMA и настройка сети
Оптимизация на уровне приложений также имеет важное значение для повышения производительности сетей, использующих искусственный интеллект.
Библиотека NVIDIA NCCL (NVIDIA Collective Communications Library) широко используется для связи между несколькими графическими процессорами и в значительной степени зависит от эффективной передачи данных по сети. Правильная настройка RDMA помогает снизить нагрузку на ЦП и повысить эффективность передачи данных между графическими процессорами.
К числу распространенных областей оптимизации относятся:
-
Настройка топологии NCCL
-
конфигурация очереди RDMA
-
Привязка к графическому процессору и выравнивание NUMA
-
Оптимизация MTU
-
Балансировка траектории движения
В совокупности эти оптимизации на сетевом и прикладном уровнях помогают снизить накладные расходы на связь и повысить масштабируемость распределенного обучения ИИ.
⭐ Кластерные сетевые модули и оптические модули для систем искусственного интеллекта
Оптические модули являются ключевым компонентом современных кластерных сетей для ИИ. По мере масштабирования кластеров GPU от сотен до тысяч ускорителей сеть должна обеспечивать чрезвычайно высокую пропускную способность, низкую задержку и надежную целостность сигнала между серверами и коммутаторами. Это сделало высокоскоростные оптические соединения необходимыми в центрах обработки данных для ИИ.
Почему оптические модули важны в архитектурах, использующих искусственный интеллект
Распределенное обучение ИИ генерирует огромный трафик между узлами GPU. Одних только медных кабелей недостаточно для эффективной поддержки высокоскоростного соединения 400G и 800G на большие расстояния внутри крупных кластеров ИИ.
Оптические модули помогают решить ряд важных задач:
-
Высокоскоростная связь между графическими процессорами
-
Передача данных с низкой задержкой
-
Масштабируемое расширение ткани с помощью листовых пластин.
-
Снижено ухудшение сигнала на расстоянии
-
Улучшенная организация кабельной системы в плотно расположенных стойках.
По мере роста кластеров ИИ оптические сети приобретают все большее значение для поддержания стабильной производительности и высокой степени использования графических процессоров.
Оптические сети 100G, 400G и 800G в кластерах искусственного интеллекта
Современные инфраструктуры искусственного интеллекта быстро переходят от сетей QSFP28 100G к сетям QSFP 400G и OSFP 800G.
1. Оптика 100G
Трансиверы 100G по-прежнему широко распространены в небольших кластерах графических процессоров, сетях хранения данных и устаревших средах искусственного интеллекта.
Типичные случаи использования включают в себя:
-
Небольшие кластеры для обучения ИИ
-
Сети вывода
-
Межсоединения для хранения данных
-
Развертывания Edge AI
2. Оптика 400G
Технология 400G стала основным выбором для многих корпоративных и гипермасштабных развертываний ИИ, поскольку она обеспечивает значительно более высокую пропускную способность для распределенной связи между графическими процессорами.
К распространенным оптическим модулям 400G относятся:
Эти модули широко используются для обеспечения связи между узлами сети (spine-to-leaf) и между узлами сети (leaf-to-server) в современных сетях искусственного интеллекта.
3. Оптика 800G
Сети 800G появляются в кластерах искусственного интеллекта следующего поколения, предназначенных для обучения сверхбольших моделей и развертывания высокопроизводительных графических процессоров.
Трансиверы 800G OSFP и QSFP-DD800 способствуют повышению:
-
Пропускная способность сети
-
Плотность портов
-
Масштабируемость ткани
-
Возможность обеспечения будущего
QSFP-DD, OSFP и разветвительные соединения
Сегодня в сетевых технологиях для искусственного интеллекта доминируют два основных форм-фактора:
1. QSFP-DD
Модули QSFP-DD широко распространены благодаря высокой плотности портов и хорошей совместимости с существующими экосистемами Ethernet.
Они обычно используются для:
-
100G
-
200G
-
400G
-
Развертывание 800G
2. OSFP
Модули OSFP разработаны для повышения энергоэффективности и тепловых характеристик, что делает их все более популярными в сетях 800G AI.
OSFP часто предпочтительнее в следующих случаях:
-
Гипермасштабные кластеры искусственного интеллекта
-
Высокопроизводительные сетевые среды на базе графических процессоров.
-
Платформы коммутаторов сверхвысокой плотности
3. Варианты прорыва
Функция разветвления позволяет одному высокоскоростному порту разделяться на несколько менее скоростных каналов, например:
-
от 400G до 4×100G
-
от 800G до 2×400G
-
от 800G до 8×100G
Разветвленные конструкции повышают гибкость и помогают оптимизировать использование портов коммутаторов в сетях искусственного интеллекта.
Выбор оптики для каналов связи кластера ИИ
Выбор оптического модуля зависит от расстояния до объекта связи, требований к пропускной способности, энергопотребления и топологии развертывания.
1. Соединения между коммутаторами
Для соединения колючек с листьями обычно требуется:
-
Более высокая пропускная способность
-
Более дальний радиус действия
-
Одномодовое волокно для крупномасштабных развертываний
В подобных сценариях обычно используются оптические системы 400G DR4, FR4 и 800G.
2. Ссылки для переключения на сервер
Соединения между оконечным и графическим сервером часто короче и могут использовать:
-
ЦАП-кабели для коротких расстояний
-
AOC для средней дальности действия
-
Многомодовая оптика SR для гибкой компоновки стоек
Правильный выбор зависит от плотности размещения оборудования в стойке и тепловых характеристик.
Оптоволокно против ЦАП против АОК
|
Технология |
Преимущества |
Ограничения |
Типичный вариант использования |
|---|---|---|---|
|
волоконная оптика |
Большая дальность действия, высокая пропускная способность, масштабируемость. |
Более высокая стоимость |
Ткани для корешка листа |
|
DAC |
Низкая стоимость, низкое энергопотребление |
Очень короткое расстояние |
Подключения в пределах одной стойки |
|
Легкий, гибкий, с большей длиной действия, чем у ЦАП. |
Более высокая стоимость, чем у ЦАП. |
Межстоечные соединения для графических процессоров |
В современных сетях кластеров ИИ большинство крупномасштабных развертываний сочетают оптоволокно, ЦАП и АОС для достижения баланса между стоимостью, плотностью размещения, энергоэффективностью и масштабируемостью.
⭐ Планирование полосы пропускания для обучения и вывода результатов ИИ
Планирование пропускной способности сети является критически важной частью проектирования сетевой инфраструктуры кластера ИИ. Недостаточная пропускная способность сети может снизить загрузку графических процессоров, увеличить время обучения и создать узкие места в сети из-за перегрузки. Правильная пропускная способность сети в значительной степени зависит от типа рабочей нагрузки, размера кластера и будущих требований к масштабированию.
Как тип рабочей нагрузки влияет на потребность в пропускной способности
Различные задачи искусственного интеллекта генерируют совершенно разные схемы трафика.
1. Нагрузка на обучающую матрицу ИИ
Распределенное обучение ИИ создает чрезвычайно высокий уровень обмена данными между графическими процессорами (GPU) во время операций синхронизации.
Как правило, для организации учебного процесса требуются следующие условия:
-
Сверхвысокая пропускная способность
-
Низкая задержка
-
Связь с поддержкой RDMA
-
Низкий коэффициент переподписки
Для эффективного обеспечения синхронизации графических процессоров в кластерах, предназначенных для обучения больших языковых моделей (LLM), часто используются сети 400G или 800G.
2. Рабочие нагрузки для вывода результатов ИИ
Для задач вывода данных обычно требуется меньше пропускной способности сети, поскольку обмен данными между узлами происходит в меньшем объеме.
В сетях вывода часто отдается приоритет следующим функциям:
-
Быстрое время отклика
-
Запрос масштабируемости
-
Эффективность затрат
-
Гибкое развертывание
Во многих средах обработки данных для вывода результатов достаточно сетей Ethernet 100G или 400G в зависимости от размера модели и объема трафика.
Масштабирование на одном узле против масштабирования на нескольких узлах
По мере масштабирования рабочих нагрузок ИИ на нескольких серверах требования к пропускной способности значительно возрастают.
1. Одноузловые системы искусственного интеллекта
Одноузловые серверы с графическими процессорами в основном используют внутренние каналы связи для графических процессоров, такие как NVLink или PCIe, что снижает зависимость от внешних сетевых подключений.
В таких условиях обычно требуется меньшая пропускная способность коммутационной сети.
2. Многоузловые кластеры ИИ
Многоузловые развертывания генерируют гораздо больший сетевой трафик, поскольку графическим процессорам необходимо постоянно синхронизировать данные между серверами.
По мере роста размера кластера:
-
Интенсивность движения с востока на запад быстро возрастает.
-
Риск заторов возрастает.
-
Низкозадержечные сети приобретают все большее значение.
-
Растёт спрос на оптические межсоединения.
Для крупных распределенных кластеров обучения часто требуются неблокирующие архитектуры типа spine-leaf 400G или 800G.
Планирование текущего и будущего роста в сфере ИИ.
Требования к инфраструктуре ИИ быстро меняются. Многие организации, первоначально развернувшие сети 100G, сейчас переходят на 400G и готовятся к масштабируемости до 800G.
При планировании архитектур, использующих искусственный интеллект, важно учитывать следующие факторы:
-
Будущее расширение возможностей графических процессоров
-
Увеличение размеров моделей
-
Более высокая плотность размещения в стеллажах
-
Пути модернизации оптических модулей
-
Мощность переключателя и мощность охлаждения
Проектирование с учетом будущей масштабируемости может сократить затраты на дорогостоящую перестройку сети в будущем.
Практические правила определения размеров для тканей AI плотностью 400 и 800 г/м²
Хотя требования различаются в зависимости от рабочей нагрузки, в современных сетях искусственного интеллекта обычно используются несколько практических рекомендаций.
1. Сети 100G
Для:
-
Небольшие кластеры графических процессоров
-
Среды вывода
-
Системы разработки и тестирования
2. Сети 400G
Рекомендуется для:
-
Средние и крупные кластеры для обучения ИИ
-
Развертывание графических процессоров в нескольких стойках
-
Высокоэффективные ткани RoCEv2
-
Современные архитектуры с ребристым основанием
Технология 400G стала основным выбором для многих корпоративных центров обработки данных, использующих искусственный интеллект.
3. Сети 800G
Лучше всего подходит для:
-
Гипермасштабная инфраструктура искусственного интеллекта
-
Сверхмасштабное распределенное обучение
-
Перспективные графические процессоры
-
Платформы коммутаторов с высокой плотностью ИИ
Сети 800G помогают повысить масштабируемость, плотность портов и эффективность использования полосы пропускания в долгосрочной перспективе по мере расширения рабочих нагрузок в области искусственного интеллекта.
⭐ Распространенные проблемы сетевого взаимодействия в кластерах ИИ и способы их решения
Даже хорошо спроектированные кластеры ИИ могут сталкиваться с проблемами сети, которые снижают загрузку графических процессоров и замедляют распределенное обучение. Поскольку рабочие нагрузки ИИ очень чувствительны к задержкам и перегрузкам, небольшие проблемы в сети могут быстро повлиять на общую производительность кластера.
Ниже приведены некоторые из наиболее распространенных проблем сетевого взаимодействия в кластерах ИИ и их практические решения.
Латентные шипы
Неожиданные скачки задержки могут нарушить синхронизацию графических процессоров и замедлить операции коллективной связи, такие как All-Reduce.
Общие причины включают в себя:
-
переподписка сети
-
Перегруженные шиповидные соединения
-
Неправильные политики QoS
-
Высокая нагрузка на процессор из-за прерываний
-
Неравномерное распределение транспортного потока
Для уменьшения скачков задержки:
-
Используйте неблокирующие или малозаполняемые сети.
-
По возможности включайте RDMA.
-
Оптимизация балансировки нагрузки ECMP
-
Улучшено согласование привязки GPU и NUMA.
-
Мониторинг использования буфера коммутатора
Постоянно низкая задержка имеет решающее значение для обеспечения эффективного распределенного обучения ИИ.
Потеря пакетов и перегрузка сети
Потеря пакетов особенно вредна в средах обучения ИИ, поскольку повторная передача может задерживать синхронизацию между тысячами графических процессоров.
Заторы на дорогах часто вызваны:
-
Интенсивное движение с востока на запад.
-
Недостаточная пропускная способность восходящего канала.
-
Плохое управление очередями
-
Интенсивное движение транспорта во время коллективных операций.
Общие решения включают в себя:
-
Внедрение технологий Ethernet без потерь
-
Правильная настройка PFC и ECN.
-
Увеличение пропускной способности сети
-
Снижение коэффициента переподписки
-
Использование интеллектуальных механизмов управления перегрузками
В сетях InfiniBand обычно предусмотрена встроенная функция управления перегрузкой, в то время как среды RoCEv2 требуют более тщательной настройки.
Неправильно настроены RDMA или RoCE.
Неправильная конфигурация RDMA является одной из наиболее распространенных причин нестабильной работы сети ИИ.
Типичные проблемы включают в себя:
-
Неправильные настройки MTU
-
Неправильная конфигурация PFC
-
Неправильная конфигурация DCB
-
Дисбаланс очереди RDMA
-
Несовместимые настройки переключателя
Симптомы могут включать:
-
нестабильность связи с графическим процессором
-
Низкий уровень производительности NCCL
-
Неожиданная потеря пакетов
-
Высокая задержка при распределенном обучении
Для повышения стабильности RDMA:
-
Стандартизация сетевой конфигурации во всем кластере.
-
Подтвердите поведение PFC и ECN.
-
Используйте согласованные настройки MTU.
-
Регулярно проверяйте производительность RDMA.
-
Мониторинг эффективности коммуникаций NCCL
Проблемы несоответствия драйверов и прошивки
Кластеры ИИ в значительной степени зависят от совместимости сетевых карт, коммутаторов, графических процессоров и операционных систем. Несоответствие микропрограммного обеспечения может привести к непредсказуемым проблемам с производительностью или сбоям RDMA.
К числу распространенных проблемных областей относятся:
-
Несоответствия в прошивке сетевой карты
-
Программная несовместимость коммутатора
-
Несоответствие драйверов графического процессора
-
Неподдерживаемые версии функций RDMA
Лучшие практики включают:
-
Поддержание стандартизации версий микропрограмм в масштабах всего кластера.
-
Проверка совместимости перед обновлением.
-
Поддержание документированных базовых версий программного обеспечения.
-
Сначала протестируем обновления в тестовых средах.
Последовательное управление встроенным ПО имеет решающее значение для стабильной работы крупномасштабных систем искусственного интеллекта.
Низкий уровень использования каналов связи в кластере.
В некоторых кластерах ИИ наблюдается неравномерное использование полосы пропускания, когда одни каналы перегружены, а другие остаются недоиспользованными.
Это часто вызвано следующими причинами:
-
Неэффективное хеширование ECMP
-
Некачественное проектирование топологии
-
Пробки на дорогах
-
Несбалансированные пути связи между графическими процессорами
Для повышения эффективности использования ткани:
-
Оптимизация топологии конструкции «шип-лист»
-
Настройка политики ECMP
-
Балансировка маршрутов трафика между коммутаторами
-
Непрерывный мониторинг распределения потока.
-
Используйте инструменты телеметрии и анализа данных о ткани.
Эффективное использование каналов связи помогает максимально увеличить доступную пропускную способность и повысить общую масштабируемость обучения ИИ.
⭐ Часто задаваемые вопросы о сетевых технологиях кластеров ИИ
В1: Какая сеть лучше всего подходит для кластера ИИ?
Выбор оптимальной сети для кластера ИИ зависит от масштаба рабочей нагрузки, требований к задержке и бюджета. В крупномасштабных распределенных средах обучения ИИ часто используется InfiniBand из-за его сверхнизкой задержки и высокой производительности RDMA. В корпоративных средах развертывания ИИ обычно выбирают RoCEv2 вместо Ethernet для достижения баланса между масштабируемостью, стоимостью и операционной гибкостью.
Вопрос 2: InfiniBand лучше, чем RoCEv2?
InfiniBand, как правило, обеспечивает меньшую задержку и более совершенное управление перегрузкой для гипермасштабных кластеров обучения ИИ. Однако RoCEv2 стал популярной альтернативой, поскольку он сочетает в себе производительность RDMA со стандартной инфраструктурой Ethernet, снижая стоимость развертывания и улучшая совместимость с корпоративными сетями.
Для многих организаций RoCEv2 обеспечивает наилучший баланс между производительностью и масштабируемостью.
В3: Нужны ли кластерам ИИ оптические сети 400G или 800G?
Современные кластеры для обучения ИИ все чаще используют оптические модули 400G и 800G для поддержки высокоскоростной связи с графическими процессорами.
-
Оптические системы 400G в настоящее время широко используются в средних и крупных проектах по внедрению ИИ.
-
Оптика 800G в основном используется в гипермасштабируемых и перспективных сетях искусственного интеллекта.
Более компактные кластеры для обработки данных и среды разработки могут эффективно работать и с сетями 100G.
Вопрос 4: Может ли Ethernet обрабатывать обучение ИИ?
Да. Современные Ethernet-сети в сочетании с технологиями RoCEv2 и RDMA могут эффективно поддерживать крупномасштабное обучение ИИ. Многие корпоративные центры обработки данных для ИИ теперь используют высокоскоростной Ethernet с конфигурациями сети без потерь для распределенных рабочих нагрузок на графических процессорах.
Однако для создания сетей искусственного интеллекта на основе Ethernet требуется тщательная настройка таких технологий, как:
-
PFC (приоритетное управление потоком)
-
ECN (явное уведомление о перегрузке)
-
DCB (мостовое соединение центров обработки данных)
Без надлежащей настройки перегрузка сети и потеря пакетов могут снизить эффективность обучения.
В5: Как оптические модули влияют на производительность кластера ИИ?
Оптические модули напрямую влияют на пропускную способность, задержку, масштабируемость и надежность сигнала в кластерных сетях для искусственного интеллекта.
Высокоскоростные трансиверы, такие как модули QSFP-DD и OSFP, позволяют:
-
Возможность подключения 400G и 800G
-
Дистанционная связь между шипом и листом
-
Высокоплотные ткани для графических процессоров
-
Более низкое ухудшение сигнала
-
Улучшенная масштабируемость для распределенных рабочих нагрузок ИИ.
Правильный выбор оптики для соединений между коммутаторами и между коммутатором и сервером помогает улучшить общую производительность кластера ИИ и масштабируемость в будущем.
⭐ Лучшие практики для будущих проектов в области сетевых технологий на основе ИИ
Поскольку инфраструктура ИИ продолжает развиваться в направлении более крупных кластеров с графическими процессорами и сетей 400G/800G, решения по проектированию сети, принимаемые сегодня, будут напрямую влиять на долгосрочную масштабируемость, операционную стабильность и стоимость развертывания. Успешные проекты по созданию кластерных сетей для ИИ больше не фокусируются только на пропускной способности — они также уделяют приоритетное внимание наблюдаемости, совместимости и будущей масштабируемости оптических сетей.
Сначала разрабатывайте систему, ориентированную на наблюдаемость.
Кластеры ИИ генерируют огромные объемы трафика между странами, что делает прозрачность и мониторинг крайне важными. Современные сети ИИ должны включать в себя:
-
Телеметрия в реальном времени
-
Мониторинг заторов
-
Анализ производительности RDMA
-
видимость взаимодействия графического процессора
-
Диагностика коммутаторов и оптических систем
Ранняя наблюдение помогает выявлять узкие места до того, как они повлияют на использование графического процессора и эффективность обучения.
Сохраняйте нейтральность по отношению к поставщику дизайна.
Зависимость от конкретного поставщика может ограничивать масштабируемость в будущем и увеличивать затраты на инфраструктуру. По возможности организациям следует проектировать архитектуры для ИИ на основе открытых стандартов Ethernet, совместимой оптики и гибких архитектур типа «магистраль-лист».
Независимая от поставщиков стратегия улучшает:
-
Аппаратная гибкость
-
Параметры обновления
-
Долгосрочный контроль затрат
-
Совместимость с оборудованием разных производителей
Стандартизация микропрограммного обеспечения и кабельной разводки.
Несоответствия в программном обеспечении являются одной из наиболее распространенных причин нестабильности сетей в системах искусственного интеллекта. Стандартизация программного обеспечения сетевых карт, программного обеспечения коммутаторов, оптических модулей и типов кабелей помогает снизить количество неожиданных проблем с совместимостью.
Лучшие практики включают:
-
Поддержание согласованных версий прошивки
-
Использование проверенных списков оптической совместимости
-
Стандартизация DAC, AOC и развертывания волоконно-оптических сетей
-
Тестирование обновлений перед запуском в производство.
Топология документа и параметры настройки
Крупные архитектуры, использующие искусственный интеллект, могут стать чрезвычайно сложными. Надлежащая документация упрощает поиск и устранение неисправностей, а также дальнейшее расширение.
К числу важных пунктов, подлежащих документированию, относятся:
-
Проектирование топологии типа «островок»
-
Настройки RDMA и RoCE
-
Политика ECMP
-
Коэффициенты переподписки
-
планы развертывания оптических модулей
-
Параметры настройки NCCL
Хорошо документированные среды проще масштабировать и поддерживать с течением времени.
Планируйте масштабирование оптических каналов, а не только портов коммутатора.
Дальнейшее развитие ИИ потребует гораздо большего, чем просто дополнительные порты коммутатора. Плотность оптической полосы пропускания, энергоэффективность и организация кабелей становятся не менее важными факторами проектирования.
Организациям, внедряющим новую инфраструктуру искусственного интеллекта, следует уже сейчас готовиться к следующему:
-
Пути миграции с 400G на 800G
-
Более высокая плотность размещения в стеллажах
-
Внедрение OSFP и QSFP-DD 800G
-
Масштабируемая волоконно-оптическая инфраструктура
-
Архитектуры ультракластеров будущего
Правильный выбор оптической экосистемы на раннем этапе может значительно снизить сложность будущих обновлений.
По мере дальнейшего развития сетевых технологий для кластеров ИИ высококачественные оптические соединения и надежные компоненты Ethernet останутся основополагающими для масштабируемой инфраструктуры графических процессоров. Для организаций, планирующих создание современных сетей ИИ, это имеет важное значение. LINK-PP Официальный магазин Компания предлагает широкий спектр высокоскоростных оптических модулей, решений DAC/AOC и сетевых устройств, предназначенных для развертывания в корпоративных средах искусственного интеллекта, высокопроизводительных вычислений и центрах обработки данных.